Warning: Undefined array key "url" in /home/c4275459/public_html/pythondatalab.com/wp-content/plugins/seo-by-rank-math/includes/modules/schema/snippets/class-author.php on line 41

coin_collector

抽出・前処理

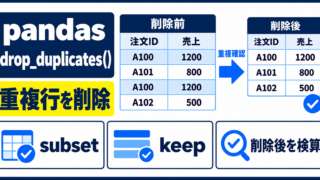
pandas drop_duplicates()の使い方|subset・keepで重複行を削除

pandasのdrop_duplicates()で重複行を安全に削除する方法を初心者向けに解説。subset・keepの選び方、削除前の確認、最新行の残し方、処理後の検算までGoogle Colabで実行できます。
基礎

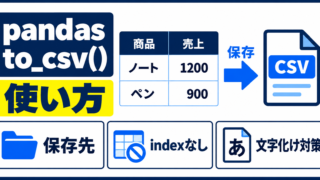
pandas to_csv()の使い方|indexなし・文字化け対策・保存先を解説

pandasのto_csv()でDataFrameをCSVに保存する方法を初心者向けに解説。index=False、文字化けを防ぐencoding、保存先、列指定、上書き・追記、保存後の確認方法までGoogle Colabで学べます。
抽出・前処理

Pandasデータ前処理の基本|読み込み後に確認する順番と欠損・型・重複の選び方

Pandasでデータ読み込み後に行う前処理の手順を解説。一律に処理するのではなく、info()での診断から空白除去、to_numeric()/astype()での型変換、欠損値・重複の判断、集計への進み方まで「確認→選択→再確認」の流れで網羅します。
抽出・前処理

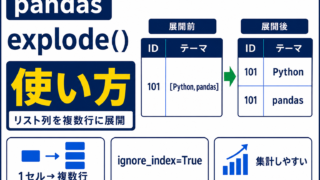
pandas explode()の使い方|リスト列を複数行に展開する方法

pandasのexplode()でリスト形式の列を複数行に展開する方法を初心者向けに解説。ignore_index、文字列の分割、複数列、空リスト・NaN、ValueErrorの原因と修正、展開後の集計まで実例で学べます。パーマリンク
基礎

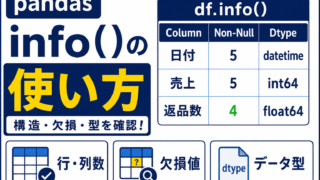
pandas info()の使い方|Non-Null Count・データ型・欠損値の見方

pandasのinfo()で行数・列数・Non-Null Count・データ型を確認する方法を初心者向けに解説。欠損値やobject型を見つけ、型変換・欠損値処理後に再確認する流れ、shape・dtypes・isnull()・describe()との違いも紹介します。