pandasで集計したあと、「どのグラフにすればよいのだろう」と迷うことがあります。グラフは見た目から選ぶのではなく、読み手に何を読み取ってほしいかと、手元のデータの形から選びます。
この記事では、比較・推移・割合/構成・分布・数値間の関係という5つの目的から図を選び、同じサンプルデータをGoogle Colabで集計・作図します。出力で最初に見る箇所、読み違えやすい点、結果が不自然なときに確認するデータも説明します。
サンプルは説明用に作った架空の店舗データです。現実の売上傾向や広告効果を示すものではありません。
この記事でわかること
- 表とグラフをどんな場面で使い分けるか
- 5つの分析目的に合う代表的なグラフ
- pandasで集計してからMatplotlibで描く基本の流れ
- 軸・順序・割合の分母・分布・点の並びをどう読むか
- グラフの形だけで結論を急がず、次に何を確認するか
先に結論:正確な値を探すなら表、全体の差やパターンをつかむならグラフを使います。カテゴリの比較は棒、時間変化は折れ線、構成比は円または100%積み上げ棒、1つの数値の分布はヒストグラム、2つの数値の関係は散布図が出発点です。複数群の分布を比べるなら箱ひげ図が候補になります。
読み進め方:全部のコードを追わなくて大丈夫
- 先に早見表から、知りたいことに合うグラフを選びます。
- 共通データの準備セルを一度だけ実行します。中の計算式を理解する必要はありません。
- 選んだグラフの章へ進み、そのコードセルだけを実行します。ほかのグラフのコードは読み飛ばして構いません。
- コードの下にある「最初に見るところ」で結果を確認します。
初めての方は、まず棒グラフの例から試してください。Notebook全体を一括実行して比較する方法もあります。
まずは「何を知りたいか」から選ぶ
| 知りたいこと | データの形・集計単位 | 最初の候補 | 出力で見るところ | 注意点 |
|---|---|---|---|---|
| カテゴリの大小を比べたい | カテゴリごとの集計値 | 棒グラフ | 棒の高さ、軸の単位、ゼロ基準 | 項目名が多いと読みにくい |
| 時間による変化を見たい | 日付と、その日時点の値 | 折れ線グラフ | 横軸の順序、上がり下がり、空白 | 日付型にして時系列順に並べる |
| 全体の構成比を見たい | 1つの全体を構成する少数項目 | 円グラフ | 各割合と合計の母数 | 項目が多いと比較しにくい。合計が全体であることを確認 |
| 複数グループの構成比を比べたい | グループ×カテゴリの集計値 | 100%積み上げ棒 | 各棒の合計が100%、区分の比率 | 各グループ内を分母にする |
| 1つの数値の分布を見たい | 個々の観測値 | ヒストグラム | 山の位置、広がり、偏り、裾 | 階級幅で見た目が変わる |
| 複数群の分布を比べたい | 群と数値 | 箱ひげ図 | 中央値、箱の幅、ひげ、外れ値候補 | 外れ値候補は誤入力とは限らない |
| 2つの数値の関係を見たい | 対になる2つの数値列 | 散布図 | 点のまとまり、傾向、離れた点 | 関連があっても因果関係とは限らない |
問いが決まらないまま作図すると、見た目は整っていても答えにならない図になりがちです。まず「誰が何を判断するために見るのか」を一文にしてから、必要な列と集計単位を決めましょう。
棒グラフと折れ線グラフは、横軸の意味で選ぶ
| 比較するもの | 選び方 | 間違えて選ぶと起きること |
|---|---|---|
| 店舗・商品など順序のないカテゴリ | 棒グラフ | 折れ線で結ぶと、カテゴリ間に連続した順序や変化があるように見える |
| 日付・時刻など順序のある時間 | 折れ線グラフ | 棒だけでは、時間の流れや変化のつながりを追いにくい |
どちらの図でも、縦軸の単位と比較対象を確認します。棒グラフは長さで差を見せるため、特別な理由がなければ縦軸を0から始めます。
Google Colabで使うサンプルデータ
ここでは30日間、3店舗、3商品カテゴリのデータを用意します。1行は「ある日・ある店舗・ある商品カテゴリ」の売上記録です。日付は時系列、売上と広告費は数値、店舗と商品カテゴリはカテゴリとして扱います。
実行目的:以降の5目的のグラフを、同じ列と同じデータから作ります。
実行前の状態:このNotebookだけで再現できるよう、固定の規則で架空データを生成します。外部ファイルのアップロードや乱数は使いません。
準備セル(最初に1回だけ実行)
次のセルは例題用データを作る準備です。最初に一度実行すればよく、ループや数式の細部は読み飛ばして大丈夫です。グラフの選び方を試すための架空データを作っています。
#@title 共通データの準備(最初に一度だけ実行)
!pip install -q japanize-matplotlib

import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib
import numpy as np
from matplotlib.ticker import PercentFormatter
from IPython.display import display

# 負の値の目盛りを読みやすく表示するための設定です。
plt.rcParams["axes.unicode_minus"] = False

dates = pd.date_range("2026-04-01", periods=30, freq="D")
stores = ["東店", "西店", "南店"]
categories = ["飲料", "食品", "日用品"]

category_base = {"飲料": 32000, "食品": 47000, "日用品": 26000}
store_factor = {"東店": 1.10, "西店": 0.92, "南店": 1.00}
# 店舗ごとの商品構成に差をつけ、構成比の比較が見えるようにします。
store_category_factor = {
    "東店": {"飲料": 0.85, "食品": 1.15, "日用品": 0.95},
    "西店": {"飲料": 1.20, "食品": 0.85, "日用品": 1.00},
    "南店": {"飲料": 0.90, "食品": 1.00, "日用品": 1.20},
}
category_index = {name: i for i, name in enumerate(categories)}
store_index = {name: i for i, name in enumerate(stores)}

rows = []
for day_index, date in enumerate(dates):
    weekend_factor = 1.08 if date.dayofweek >= 5 else 1.0
    for store in stores:
        for category in categories:
            ad_spend = (
                420
                + 70 * category_index[category]
                + 55 * store_index[store]
                + 4 * day_index
                + 35 * (day_index % 4)
            )
            trend_factor = 1 + 0.0025 * day_index
            sales = (
                category_base[category]
                * store_factor[store]
                * store_category_factor[store][category]
                * weekend_factor
                * trend_factor
                + 450 * (day_index % 5)
            )
            rows.append({
                "日付": date,
                "店舗": store,
                "商品カテゴリ": category,
                "売上": round(sales),
                "広告費": ad_spend,
            })

df = pd.DataFrame(rows)

print("行数・列数:", df.shape)
print("欠損値の数:")
display(df.isna().sum().to_frame("欠損数"))
print("先頭5行:")
display(df.head())
行数・列数: (270, 5) 欠損値の数:
| 欠損数 | |
|---|---|
| 日付 | 0 |
| 店舗 | 0 |
| 商品カテゴリ | 0 |
| 売上 | 0 |
| 広告費 | 0 |
先頭5行:
| 日付 | 店舗 | 商品カテゴリ | 売上 | 広告費 | |
|---|---|---|---|---|---|
| 0 | 2026-04-01 | 東店 | 飲料 | 29920 | 420 |
| 1 | 2026-04-01 | 東店 | 食品 | 59455 | 490 |
| 2 | 2026-04-01 | 東店 | 日用品 | 27170 | 560 |
| 3 | 2026-04-01 | 西店 | 飲料 | 35328 | 475 |
| 4 | 2026-04-01 | 西店 | 食品 | 36754 | 545 |
最初にデータの単位・型・欠損を確かめる
出力の先頭では、1行に何が記録されているか、日付が日付型か、売上・広告費が数値かを見ます。今回の表は270行(30日×3店舗×3カテゴリ)です。同じ店舗・日付が複数行あるのは商品カテゴリごとの記録だからで、重複エラーではありません。
自分のCSVへ置き換える場合は、列名だけでなく「1行が何を表すか」も確認します。日付が文字列なら時系列順に並べる前に日付型へ変換し、集計の単位に応じて重複行や欠損の意味を確かめます。
正確な売上額を比べたい場合(任意)
次のクロス集計表は、グラフではなく正確な金額を確認するための例です。早見表で「個々の値を確認したい」と判断した場合に見てください。
print("データ型:")
display(df.dtypes.to_frame("データ型"))
print("店舗・カテゴリごとの記録数:")
display(df.groupby(["店舗", "商品カテゴリ"]).size().unstack())
print("重複行数:", df.duplicated().sum())
データ型:
| データ型 | |
|---|---|
| 日付 | datetime64[ns] |
| 店舗 | object |
| 商品カテゴリ | object |
| 売上 | int64 |
| 広告費 | int64 |
店舗・カテゴリごとの記録数:
| 商品カテゴリ | 日用品 | 食品 | 飲料 |
|---|---|---|---|
| 店舗 | |||
| 南店 | 30 | 30 | 30 |
| 東店 | 30 | 30 | 30 |
| 西店 | 30 | 30 | 30 |
重複行数: 0
# 任意:店舗×商品カテゴリのクロス集計表(正確な数値を比較)
pivot_sales = df.pivot_table(
    index="店舗",
    columns="商品カテゴリ",
    values="売上",
    aggfunc="sum",
    margins=True,
    margins_name="合計"
)
display(pivot_sales)| 商品カテゴリ | 日用品 | 食品 | 飲料 | 合計 |
|---|---|---|---|---|
| 店舗 | ||||
| 南店 | 1017597 | 1519249 | 941397 | 3478243 |
| 東店 | 889646 | 1914691 | 976957 | 3781294 |
| 西店 | 786458 | 1193936 | 1148659 | 3129053 |
| 合計 | 2693701 | 4627876 | 3067013 | 10388590 |
1. カテゴリ比較:棒グラフ(この図を選んだ場合)
問い:30日間の売上合計は、どの商品カテゴリで大きかったでしょうか。
まずpandasで商品カテゴリごとに売上を合計します。棒グラフへ渡す前に、集計結果の並びと値が意図したものか表で確かめます。
処理前後の違い:元のdfは日付・店舗・カテゴリごとの明細です。sales_by_categoryは30日間・全店舗をまとめ、カテゴリごとに1行にした集計表です。
sales_by_category = (
    df.groupby("商品カテゴリ")["売上"]
      .sum()
      .sort_values(ascending=False)
)
display(sales_by_category.to_frame("30日間の売上"))

fig, ax = plt.subplots(figsize=(7, 4))
sales_by_category.sort_values().plot(kind="bar", ax=ax, color="#4C78A8")
ax.set_title("商品カテゴリ別の売上合計")
ax.set_xlabel("商品カテゴリ")
ax.set_ylabel("売上(円)")
ax.set_ylim(bottom=0)
ax.grid(axis="y", alpha=0.25)
plt.xticks(rotation=0)
plt.tight_layout()
plt.show()| 30日間の売上 | |
|---|---|
| 商品カテゴリ | |
| 食品 | 4627876 |
| 飲料 | 3067013 |
| 日用品 | 2693701 |
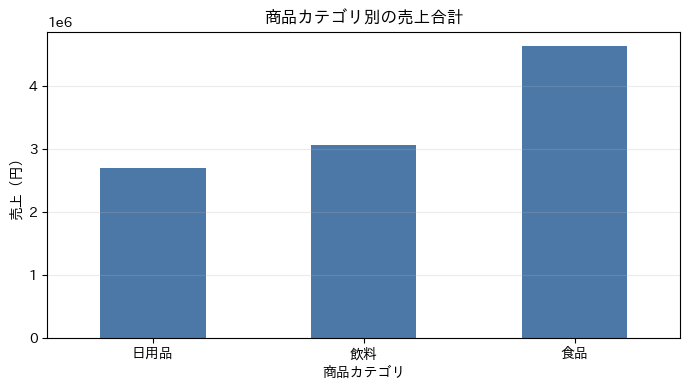
棒グラフで最初に見るところ
- 表では「30日間の売上」が大きい順に並んでいます。棒の高さと表の数値が対応しているかを見ます。
- 縦軸は円で、0から始まっています。基準を切り詰めると小さな差が大きく見えることがあります。
- この集計は30日間・全店舗の合計です。店舗別の違いを知りたいなら、店舗とカテゴリの両方で集計し直します。
店舗名など順序のない項目を折れ線で結ぶと、横軸に連続的な意味があるように見えるため、この問いには棒が向いています。
2. 時間変化:折れ線グラフ(この図を選んだ場合)
問い:全店舗・全カテゴリを合わせた日次売上は、期間中にどのように変化したでしょうか。
日付ごとに売上を合計してから描きます。明細をそのまま描くと、同じ日付の複数行が重なり、日ごとの合計という問いに答えられません。
daily_sales = (
    df.groupby("日付", as_index=False)["売上"]
      .sum()
      .sort_values("日付")
)
display(daily_sales.head())
print("日付の昇順:", daily_sales["日付"].is_monotonic_increasing)
print("日次集計の行数:", len(daily_sales))

fig, ax = plt.subplots(figsize=(9, 4))
ax.plot(daily_sales["日付"], daily_sales["売上"], marker="o", linewidth=1.8)
ax.set_title("日次売上の推移(全店舗・全カテゴリ)")
ax.set_xlabel("日付")
ax.set_ylabel("売上(円)")
ax.grid(alpha=0.25)
fig.autofmt_xdate()
plt.tight_layout()
plt.show()| 日付 | 売上 | |
|---|---|---|
| 0 | 2026-04-01 | 319547 |
| 1 | 2026-04-02 | 324397 |
| 2 | 2026-04-03 | 329246 |
| 3 | 2026-04-04 | 359849 |
| 4 | 2026-04-05 | 364763 |
日付の昇順: True
日次集計の行数: 30
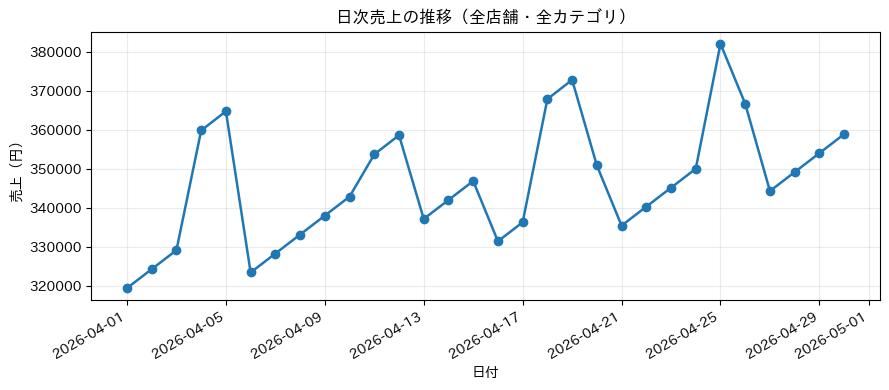
折れ線グラフで最初に見るところ
横軸が日付順であることを先に確認します。出力には日次集計が30行あり、日付は昇順です。折れ線の上下は全店舗・全カテゴリの合計の変化を表します。曜日による上下や期間中の傾きが見えても、それだけで原因までは分かりません。
線が前後に飛ぶ場合は、日付が文字列のままではないか、ソートされているか、同じ日付に複数の未集計行が残っていないかを確認します。日付型への変換やソートを直した後、集計表の日付と行数をもう一度見ます。
3. 割合・構成:円グラフと100%積み上げ棒(この図を選んだ場合)
割合の図は、分母が何かを決めてから作ります。全期間・全店舗の売上構成を1つの全体として見るなら円グラフ、店舗ごとの構成比を比べるなら店舗を1本ずつにした100%積み上げ棒が候補です。
ここではカテゴリが3つと少ないため、全店舗の合計構成を円で示します。同時に店舗ごとの構成比も計算します。店舗別の比率は、各店舗の売上合計を分母にします。
category_sales = df.groupby("商品カテゴリ")["売上"].sum()
category_share = category_sales / category_sales.sum()

store_category_sales = df.pivot_table(
    index="店舗", columns="商品カテゴリ", values="売上", aggfunc="sum"
)
store_category_share = store_category_sales.div(
    store_category_sales.sum(axis=1), axis=0
)

print("全体構成比(全店舗・全期間が分母):")
display(category_share.mul(100).round(1).to_frame("構成比(%)"))
print("店舗ごとの構成比(各店舗の合計が分母):")
display(store_category_share.mul(100).round(1))
print("店舗ごとの構成比合計(100%になることを確認):")
display(store_category_share.sum(axis=1).mul(100).round(1).to_frame("合計(%)"))

fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
axes[0].pie(
    category_sales,
    labels=category_sales.index,
    autopct="%1.1f%%",
    startangle=90,
    counterclock=False,
)
axes[0].set_title("全店舗・全期間の売上構成")
axes[0].axis("equal")

bottom = np.zeros(len(store_category_share))
for category in categories:
    values = store_category_share[category].to_numpy()
    axes[1].bar(
        store_category_share.index, values, bottom=bottom, label=category
    )
    bottom += values
axes[1].set_title("店舗別の商品カテゴリ構成")
axes[1].set_xlabel("店舗")
axes[1].set_ylabel("構成比")
axes[1].set_ylim(0, 1)
axes[1].yaxis.set_major_formatter(PercentFormatter(xmax=1))
axes[1].legend(title="商品カテゴリ")
plt.tight_layout()
plt.show()
全体構成比(全店舗・全期間が分母):
| 構成比(%) | |
|---|---|
| 商品カテゴリ | |
| 日用品 | 25.9 |
| 食品 | 44.5 |
| 飲料 | 29.5 |
店舗ごとの構成比(各店舗の合計が分母):
| 商品カテゴリ | 日用品 | 食品 | 飲料 |
|---|---|---|---|
| 店舗 | |||
| 南店 | 29.3 | 43.7 | 27.1 |
| 東店 | 23.5 | 50.6 | 25.8 |
| 西店 | 25.1 | 38.2 | 36.7 |
店舗ごとの構成比合計(100%になることを確認):
| 合計(%) | |
|---|---|
| 店舗 | |
| 南店 | 100.0 |
| 東店 | 100.0 |
| 西店 | 100.0 |
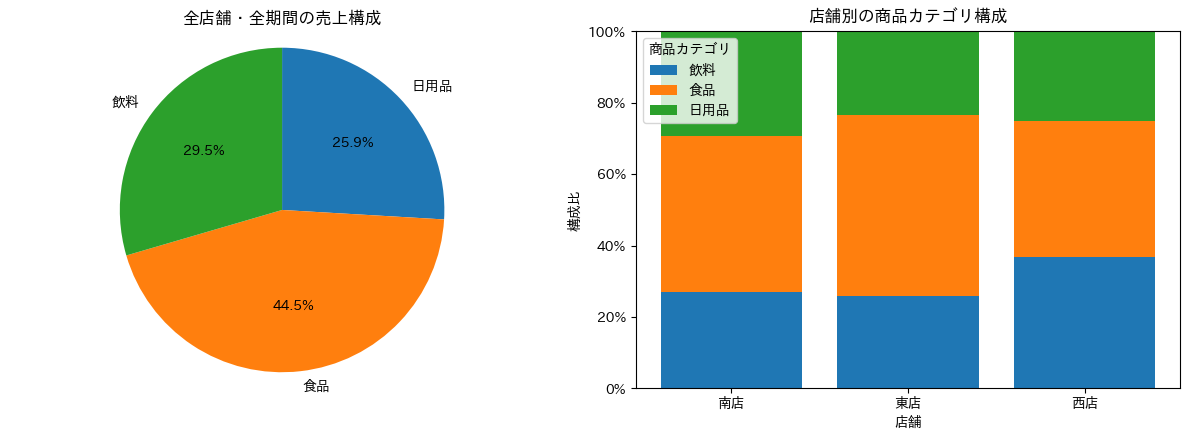
割合の出力で確認するところ
- 円グラフの分母は、全店舗・全期間の売上合計です。表示された各カテゴリの割合は、その全体に占める割合です。
- 右の棒は店舗ごとに合計が100%です。各店のカテゴリ構成を比べる図なので、棒の高さ自体から店舗の売上規模は比べられません。
- 表の「店舗ごとの構成比合計」は、すべて100.0%になることを確認します。
円グラフは少数項目の1つの全体を示すときに使いやすい一方、多数の項目や近い比率の比較には向きません。店舗間の構成比比較では、円を複数並べるより100%積み上げ棒の方が同じ軸で比べやすくなります。
誤解しやすい点:100%積み上げ棒は構成比を比べます。東店の売上合計が西店より大きいかは、この図では分かりません。規模も比較するなら、売上合計を示す別の棒グラフを見ます。
4. 数値間の関係:散布図(この図を選んだ場合)
問い:東店・食品カテゴリについて、30日分の広告費と売上にどのような並びが見えるでしょうか。
店舗・カテゴリの違いによる売上水準の差を混ぜないよう、ここでは1店舗・1カテゴリに絞ります。広告費と売上の関係が見えても、広告が売上を増やしたという因果関係の証明にはなりません。日数の経過や曜日など別の要因が関係する可能性があります。
scatter_data = df.loc[
    (df["店舗"] == "東店") & (df["商品カテゴリ"] == "食品")
].copy()

fig, ax = plt.subplots(figsize=(7, 5))
ax.scatter(scatter_data["広告費"], scatter_data["売上"], alpha=0.75, edgecolors="none")
ax.set_title("東店・食品の広告費と売上(1点=1日)")
ax.set_xlabel("広告費(円)")
ax.set_ylabel("売上(円)")
ax.grid(alpha=0.25)
plt.tight_layout()
plt.show()

print("相関係数(線形な関係の目安):", round(scatter_data["広告費"].corr(scatter_data["売上"]), 3))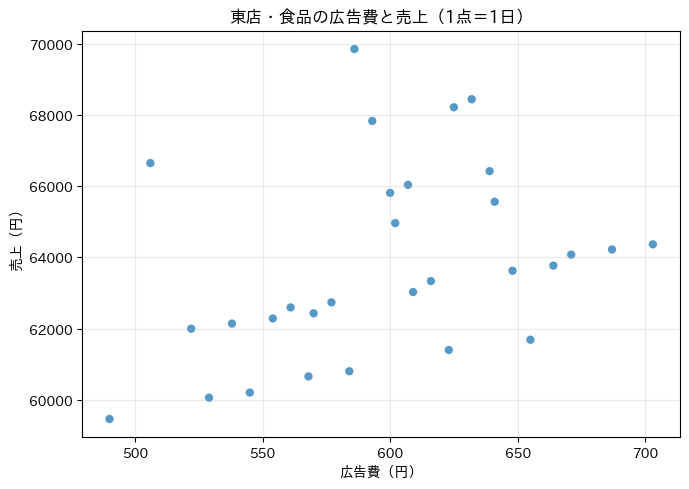
相関係数(線形な関係の目安): 0.358
散布図で最初に見るところ
横軸と縦軸の単位を確認し、点が右上がり・右下がりに並ぶか、まとまりが複数あるか、離れた点があるかを見ます。相関係数はこの例で数値同士が直線的にどの程度一緒に動くかの目安ですが、原因や効果の大きさを示す数字ではありません。
この架空データでは広告費と売上の両方に日数に応じた変化を持たせています。時間経過という共通要因だけでも、2つの値が一緒に動いて見えることがあります。そのため、この相関係数や散布図から現実の広告効果を推定することはできません。実データでは期間をそろえ、必要なら店舗・商品カテゴリなどに分けて形を再確認します。
5. 分布:ヒストグラム・箱ひげ図(この図を選んだ場合)
問い:1件あたりの売上はどの範囲に多く、商品カテゴリごとに中央値や広がりは違うでしょうか。
ヒストグラムは1つの数値列の分布形状を見る図です。箱ひげ図は複数群の中央値や四分位範囲などを手短に比べるときに便利です。箱ひげ図は分布の細かな形をすべて表すわけではないので、必要ならヒストグラムも確認します。
print("売上の要約:")
display(df["売上"].describe().round(0).to_frame("売上(円)"))

fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
axes[0].hist(df["売上"], bins=12, color="#72A0C1", edgecolor="white")
axes[0].set_title("1件あたり売上の分布")
axes[0].set_xlabel("売上(円)")
axes[0].set_ylabel("記録数")
axes[0].grid(axis="y", alpha=0.25)

box_data = [df.loc[df["商品カテゴリ"] == category, "売上"] for category in categories]
axes[1].boxplot(box_data)
axes[1].set_xticks(range(1, len(categories) + 1))
axes[1].set_xticklabels(categories)
axes[1].set_title("商品カテゴリ別の売上分布")
axes[1].set_xlabel("商品カテゴリ")
axes[1].set_ylabel("売上(円)")
axes[1].grid(axis="y", alpha=0.25)
plt.tight_layout()
plt.show()
売上の要約:
| 売上(円) | |
|---|---|
| count | 270.0 |
| mean | 38476.0 |
| std | 11345.0 |
| min | 23920.0 |
| 25% | 30776.0 |
| 50% | 34460.0 |
| 75% | 41232.0 |
| max | 69864.0 |
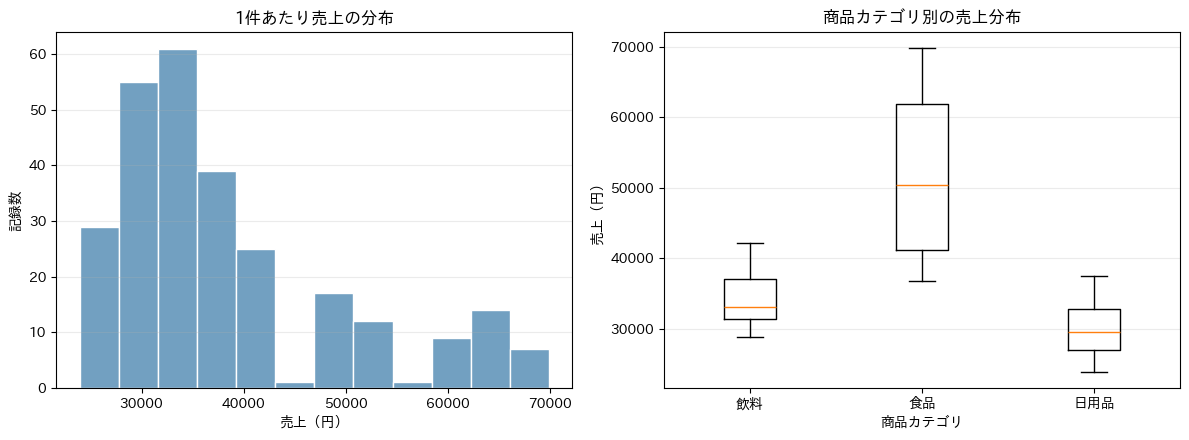
分布図で最初に見るところ
- ヒストグラムでは、横軸が売上、縦軸が記録数です。山がどこにあるか、左右どちらに長い裾があるか、値の幅がどれくらいかを見ます。
- 箱ひげ図では、箱の中の線が中央値、箱が中央50%の範囲を表します。点が表示される設定では、外れ値候補として示されることがあります。
- 外れ値候補は、必ずしも誤入力ではありません。元の行へ戻り、単位・入力ミス・実際に起きた特殊な状況を確認します。
ヒストグラムの階級幅(bins)を変えると山の見え方が変わります。階級幅を変えただけでデータ自体が変わったわけではありません。結論が階級幅に強く左右されるなら、設定を変えて形を見比べ、表の要約値や元データも確認します。
グラフが空・順序が変・割合が合わないとき
| 起きる現象 | よくある原因 | 確認するもの | 修正の方向 |
|---|---|---|---|
| グラフが空、点や棒が少ない | 対象列が欠損、数値が文字列、絞り込み条件で行がなくなった | df.dtypes、df.isna().sum()、絞り込み後のshape | 列の型・欠損・条件を確認してから集計する |
| 折れ線が前後に飛ぶ | 日付が未変換、未ソート、同じ日付の明細を未集計 | 日付の型、昇順か、集計表の行数 | 日付型へ変換し、目的の単位で集計してからソート |
| 店舗ごとの割合合計が100%でない | 分母が全店舗合計など、比較したいグループとずれている | 各行の分母、欠損カテゴリ、重複記録 | 「店舗ごと」に比べるなら各店舗の合計で割る |
| 円グラフの区分が多く読めない | 項目数が多い、比率が近い | 区分数、隣接ラベル、構成比表 | 棒グラフや集約で見せ方を見直す |
| 点や箱ひげ図の外れた値が気になる | 特殊な実績、単位違い、入力誤りなどが混在 | 該当する元の行、単位、同じ条件の記録 | 事実を確認し、誤りと分かった値だけ適切に修正する |
グラフの体裁を直す前に、pandasで作った集計表へ戻るのが近道です。入力データ → 集計後の表 → 図の順に確認すると、どの段階で結果が想定と違ったかを切り分けやすくなります。
任意:店舗別構成比で分母を間違える例
店舗ごとの構成比を比較するのに全店舗合計で割ると、各店舗の棒の合計が100%になりません。コード自体は実行できても、問いたい割合と違う値を描いてしまう例です。
このコードは分母の違いを確かめる補足です。基本のグラフ選びだけを学ぶ場合は、実行を省略できます。
# 誤った例:全店舗共通の合計を分母にしてしまう
wrong_share = store_category_sales / store_category_sales.to_numpy().sum()
print("誤った分母で計算した店舗ごとの合計(100%にならない):")
display(wrong_share.sum(axis=1).mul(100).round(1).to_frame("合計(%)"))

# 修正版:各店舗の合計を分母にする
correct_share = store_category_sales.div(store_category_sales.sum(axis=1), axis=0)
print("修正後の店舗ごとの合計:")
display(correct_share.sum(axis=1).mul(100).round(1).to_frame("合計(%)"))
誤った分母で計算した店舗ごとの合計(100%にならない):
| 合計(%) | |
|---|---|
| 店舗 | |
| 南店 | 33.5 |
| 東店 | 36.4 |
| 西店 | 30.1 |
修正後の店舗ごとの合計:
| 合計(%) | |
|---|---|
| 店舗 | |
| 南店 | 100.0 |
| 東店 | 100.0 |
| 西店 | 100.0 |
誤った計算では「店舗ごと」ではなく、「全店舗合計に対する各店舗の割合」を計算しています。修正後に各行の合計が100%になることを確認します。割合を出すときは、図の種類より先に「何を100%とするか」を明確にしましょう。
自分のデータに置き換える前の確認リスト
- 1行の単位: 1行は何日の、どの店舗・商品・顧客などを表しているか。
- 列の型と単位: 日付は日時型か。売上は円か千円か。数値が文字列になっていないか。
- 集計単位: 明細をそのまま描くのか、日別・店舗別などに集計するのか。
- 順序: 時系列は昇順か。カテゴリに順序があるなら、その順序が意図どおりか。
- 分母: 割合は全体、店舗ごと、期間ごとのどれを100%とするのか。
- 欠損・重複・件数: 集計に含まれていない行があるか。グループごとの件数が極端に違わないか。
- 軸と範囲: 単位、ゼロ基準、比較するグループが読み手に分かるか。
列名が違う場合は、コード中の列名を自分のDataFrameに合わせて変更してください。先に head() ・ dtypes ・欠損数を確認し、表で集計結果を確かめてから作図すると、誤った列や単位で描く失敗を防ぎやすくなります。
図で見つけたことを次の分析へつなげる
グラフは結論を自動で出すものではなく、詳しく確認する箇所を見つける手掛かりです。
- 特定カテゴリの売上が大きいなら、店舗や期間に分けて再集計する。
- 時系列で急に変化した日があれば、その日の元データや別の期間を抽出して確かめる。
- 構成比が違う店舗があれば、構成比だけでなく売上規模・件数も並べて見る。
- 散布図で離れた点があれば、元の行、記録単位、単位や入力値を確認する。
- 分布の偏りがあれば、中央値や分位点、群ごとの件数を調べる。
集計手順を詳しく確認したい場合は、pandasのgroupby・aggで集計する、value_counts()で件数を数える、corr()で相関行列を確認するへ進めます。DataFrameの基本はPandas DataFrameから次の分析へ進むで確認できます。
図を選んだ後の詳しい作図は、Matplotlibの棒グラフ、折れ線グラフ、散布図、ヒストグラムと箱ひげ図の記事へ。図の土台はFigureとAxesの基本で確認できます。
まとめ
- 表は正確な値を探すとき、グラフは差・変化・構成・分布・関係のパターンをつかむときに使います。
- カテゴリ比較は棒、時間変化は折れ線、全体の構成比は円、群ごとの構成比は100%積み上げ棒、数値間の関係は散布図、分布はヒストグラムや箱ひげ図が出発点です。
- 描く前に、列の型・1行の単位・集計単位・割合の分母を確認します。
- 出力は軸、単位、並び、合計、点の配置、分布の形から読みます。
- 図だけで因果関係やデータの誤りを断定せず、気付いた箇所を集計表や元データへ戻って確認します。
迷ったら、まず「読み手に何を判断してほしいか」を一文で決め、その問いに必要な列と集計単位を選びましょう。
目的に合うグラフを選ぶには、何から決めますか?
まず読み手に何を知ってほしいかを決めます。正確な数値が必要なら表、差を比べるなら棒、時間変化なら折れ線、構成比なら円や100%積み上げ棒、分布ならヒストグラムや箱ひげ図、2つの数値の関係なら散布図を候補にします。
表とグラフはどう使い分けますか?
個々の正確な値を探したり照合したりするなら表、全体の傾向やグループ間のパターンをつかみたいならグラフが向いています。両方必要な場面では、グラフで注目箇所を見つけ、表で値を確かめます。
円グラフと帯グラフはどう選びますか?
少数項目からなる1つの全体の構成を示すなら円グラフが候補です。店舗や期間など複数グループの構成比を比べるなら、各グループを100%にそろえた積み上げ棒が比較しやすくなります。どちらも分母を明示します。
ヒストグラムと箱ひげ図はどう使い分けますか?
1つの数値列の山・偏り・裾など分布の形を見たいならヒストグラム、複数群の中央値や広がりを簡潔に比べたいなら箱ひげ図が候補です。箱ひげ図だけでは分布の形が分かりにくいことがあります。
散布図で相関があれば、因果関係もあるといえますか?
いいえ。散布図や相関係数は数値同士の関係を確認する手掛かりですが、片方がもう片方を引き起こした証明にはなりません。時期、店舗、商品など別の要因や、データの集め方も確認します。
グラフにする前にpandasで何を確認しますか?
列の型、欠損、1行の単位、集計単位、日付やカテゴリの順序、グループごとの件数を確認します。割合を作るときは、何を分母にするかも決めてください。
コメント