このカテゴリでは、Pandasを使ったデータ抽出やフィルタリング、欠損値処理、重複データの削除など、分析前の前処理に関する操作を解説します。loc・iloc・isin・dropなどの具体的なサンプルコードを用いて、実務での活用方法を学びます。
 抽出・前処理
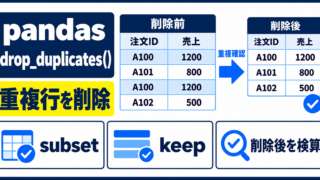
pandas drop_duplicates()の使い方|subset・keepで重複行を削除
pandasのdrop_duplicates()で重複行を安全に削除する方法を初心者向けに解説。subset・keepの選び方、削除前の確認、最新行の残し方、処理後の検算までGoogle Colabで実行できます。
 抽出・前処理
Pandasデータ前処理の基本|読み込み後に確認する順番と欠損・型・重複の選び方
Pandasでデータ読み込み後に行う前処理の手順を解説。一律に処理するのではなく、info()での診断から空白除去、to_numeric()/astype()での型変換、欠損値・重複の判断、集計への進み方まで「確認→選択→再確認」の流れで網羅します。
 抽出・前処理
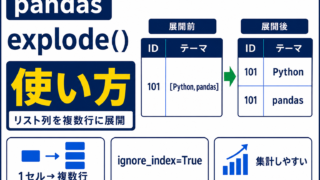
pandas explode()の使い方|リスト列を複数行に展開する方法
pandasのexplode()でリスト形式の列を複数行に展開する方法を初心者向けに解説。ignore_index、文字列の分割、複数列、空リスト・NaN、ValueErrorの原因と修正、展開後の集計まで実例で学べます。パーマリンク
抽出・前処理 pandas str.strip()の使い方|文字列・列名の前後空白を削除する方法
pandasのstr.strip()で文字列の前後にある半角・全角スペースを削除する方法を初心者向けに解説。str.lstrip()・str.rstrip()との違い、列名の空白除去、NaNや混在列の注意点もサンプルコードで確認します。
 抽出・前処理
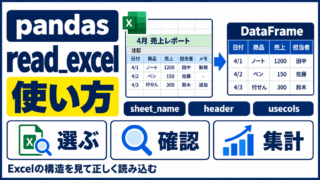
pandas read_excel()の使い方|Excel読み込み・sheet_name・header・usecolsを初心者向けに解説
.colab-article pre.line-numbers, .colab-article pre.colab-output { margin-top: 0 !important; margin-bottom: 0 !important...