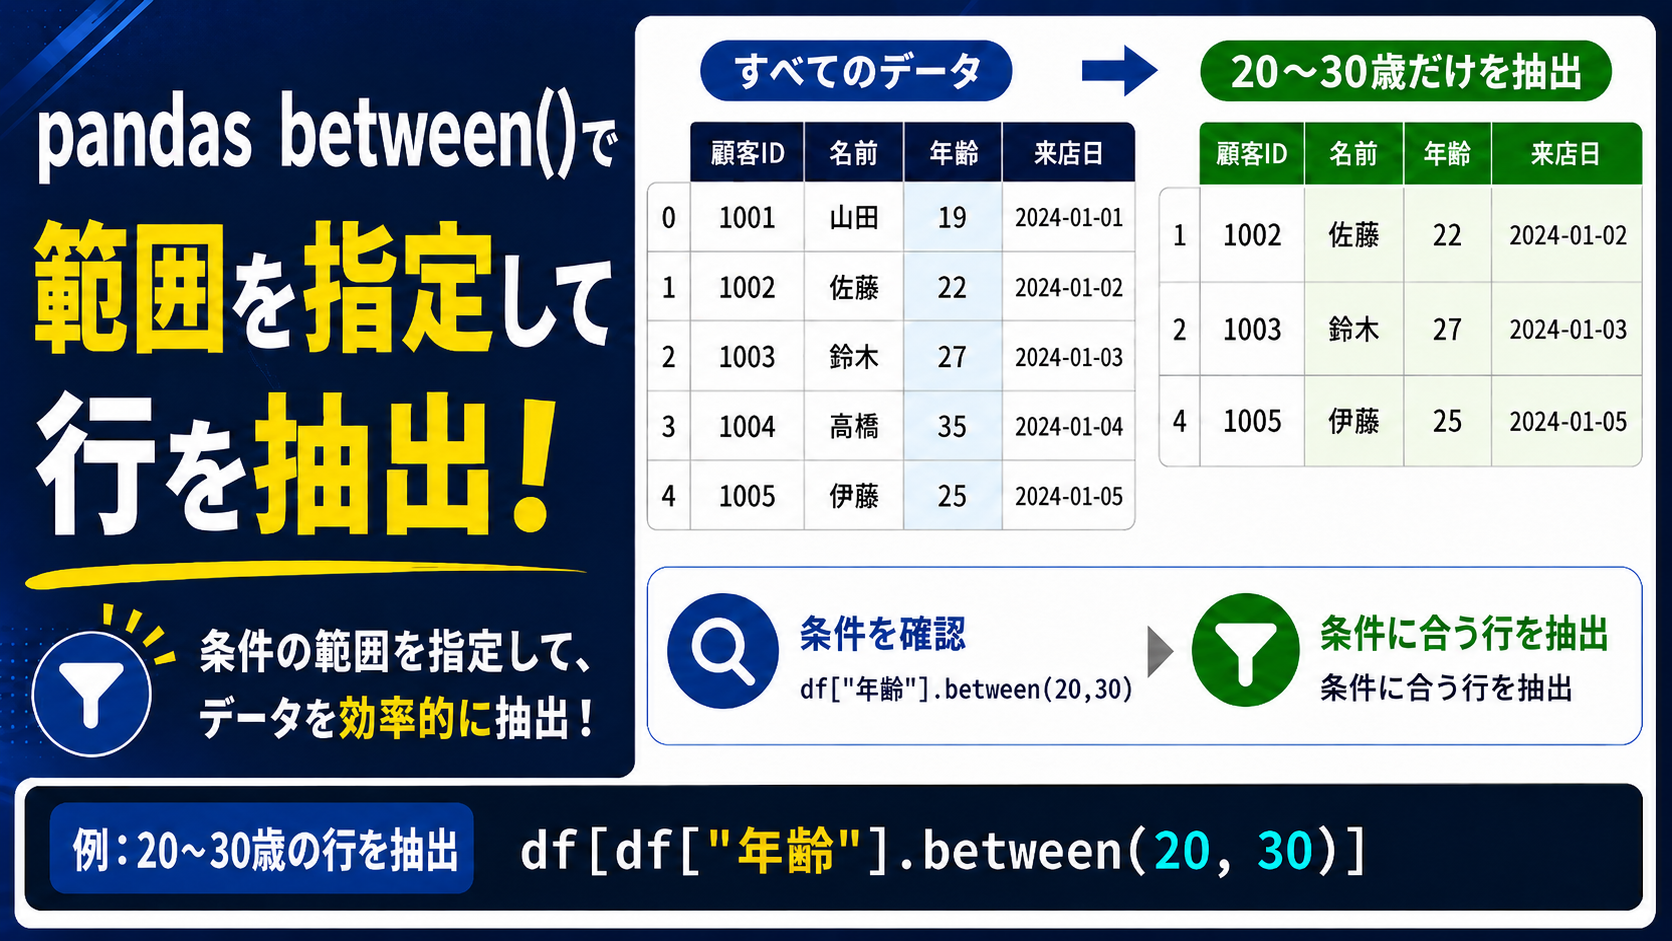
CSVを読み込んだあと、DataFrameの中から 「一定の範囲に入る行だけ」 を取り出したいことがあります。
たとえば、次のような場面です。
- 売上が1000円〜5000円の商品だけ見たい
- 2026年1月の注文だけ確認したい
- 年齢が20歳〜40歳の人だけ抽出したい
このような 数値や日付の範囲で行を絞り込む処理 に使えるのが、Pandasの between() です。
between() を使うと、たとえば「売上が1000円以上5000円以下の行」を、次のように短く書けます。
df[df["売上"].between(1000, 5000)]
つまり、between() は 1つの列を「下限〜上限」の範囲で抽出したいときに使う方法 です。
この記事では、between() を使って、数値や日付の範囲で行を抽出する方法を、サンプルデータで順番に確認します。あわせて、範囲の始まりと終わりを含めるかどうか、between() と同じ範囲抽出を、>=・<= や query() で書く方法も確認します。
また、範囲に関係する処理として cut() もあります。ただし、cut() は between() と同じ結果を出すための方法ではありません。between() は「範囲に入る行を抽出する」処理、cut() は「値を区間に分ける」処理です。この違いは、本文後半で具体例を使って確認します。
この記事でわかること
この記事では、次の内容を順番に確認します。
between()とは何か、範囲抽出の基本- 数値を範囲で抽出する方法
- 日付を範囲で抽出する方法
inclusiveで数値や日付の範囲の境界値を含める・含めない設定between()と>=・<=・query()・cut()の違い- 範囲抽出後に集計・可視化へつなげる考え方
やりたいこと別:between()を使う場面
between() は、1つの列を「下限〜上限」の範囲で絞りたいときに使います。
| やりたいこと | 使う方法 | 例 |
|---|---|---|
| 数値を範囲で抽出したい | between() |
売上1000円〜5000円 |
| 日付を範囲で抽出したい | between() |
2026年1月の注文 |
| 同じ範囲抽出を別の書き方で書きたい | 比較演算子・query() |
>=・<= や query() |
| 範囲で抽出ではなく、区間に分けたい | cut() |
売上を低価格・中価格・高価格に分類 |
between() は、連続した範囲で行を絞り込むときに向いています。
候補リストから選ぶ場合や、文字列を含む行を探す場合は、後半の「between()を使わない場面」で軽く整理します。
サンプルデータを用意する
ここでは、ECサイトの注文データを例にします。
売上 と 注文日 を使って、数値と日付の範囲抽出を確認していきます。
import pandas as pd

data = {
    "注文日": ["2026-01-03", "2026-01-08", "2026-01-15", "2026-01-28", "2026-02-04", "2026-02-12", "日付不明"],
    "商品": ["ノートPC", "マウス", "キーボード", "USBメモリ", "モニター", "Webカメラ", "ケーブル"],
    "カテゴリ": ["PC", "周辺機器", "周辺機器", "周辺機器", "PC", "周辺機器", "周辺機器"],
    "売上": [120000, 1000, 4800, 980, 5000, None, 3200]
}

df = pd.DataFrame(data)
df
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 0 | 2026-01-03 | ノートPC | PC | 120000.0 |
| 1 | 2026-01-08 | マウス | 周辺機器 | 1000.0 |
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 3 | 2026-01-28 | USBメモリ | 周辺機器 | 980.0 |
| 4 | 2026-02-04 | モニター | PC | 5000.0 |
| 5 | 2026-02-12 | Webカメラ | 周辺機器 | NaN |
| 6 | 日付不明 | ケーブル | 周辺機器 | 3200.0 |
この時点では、注文日 は文字列として入っています。日付の範囲抽出をするときは、あとで pd.to_datetime() を使って日付型に変換します。
数値を範囲で抽出する方法
ここからは、売上 列を使って between() の動きを確認します。
between() は、いきなり行を取り出すのではなく、まず各行が範囲内かどうかを判定します。
まずbetween()で範囲内かどうかを判定する
between() は、最初に各行の値が指定した範囲に入っているかどうかを、True / False で判定します。
たとえば、売上 が1000円以上5000円以下かどうかを判定してみます。
df["売上"].between(1000, 5000)
| 売上 | |
|---|---|
| 0 | False |
| 1 | True |
| 2 | True |
| 3 | False |
| 4 | True |
| 5 | False |
| 6 | True |
True は範囲内、False は範囲外という意味です。
この判定結果を使うと、次のステップで True の行だけを抽出できます。
判定結果を使って行を抽出する
範囲内かどうかを判定できたら、その条件を df[...] に入れます。
これで、売上 が1000円以上5000円以下の行だけを抽出できます。
売上範囲内 = df[df["売上"].between(1000, 5000)]
売上範囲内
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 1 | 2026-01-08 | マウス | 周辺機器 | 1000.0 |
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 4 | 2026-02-04 | モニター | PC | 5000.0 |
| 6 | 日付不明 | ケーブル | 周辺機器 | 3200.0 |
このコードでは、売上 が1000円以上5000円以下の行だけが残ります。
ポイントは、1000円ちょうどの行も、5000円ちょうどの行も含まれることです。between() は、初期設定では両端の値を含みます。
between() は、売上だけでなく、年齢・点数・価格など、範囲で絞りたい数値列にも同じように使えます。
日付を範囲で抽出する方法
between() は、数値だけでなく日付にも使えます。
ただし、CSVから読み込んだ日付列は、文字列のままになっていることがあります。日付の範囲抽出をする前に、pd.to_datetime() で日付型に変換しておきます。
df["注文日"] = pd.to_datetime(df["注文日"], errors="coerce")
df
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 0 | 2026-01-03 | ノートPC | PC | 120000.0 |
| 1 | 2026-01-08 | マウス | 周辺機器 | 1000.0 |
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 3 | 2026-01-28 | USBメモリ | 周辺機器 | 980.0 |
| 4 | 2026-02-04 | モニター | PC | 5000.0 |
| 5 | 2026-02-12 | Webカメラ | 周辺機器 | NaN |
| 6 | NaT | ケーブル | 周辺機器 | 3200.0 |
このセルを実行すると、df["注文日"] は日付型に変換されます。
そのため、以降の df では、日付として変換できなかった "日付不明" は NaT と表示されます。
errors="coerce" を指定すると、日付に変換できない値は NaT に変わります。
今回のデータでは、"日付不明" は日付として変換できません。errors="coerce" を指定しないとエラーになりますが、指定しておけば NaT に変換され、処理を続けられます。
次に、2026年1月1日から2026年1月31日までの注文だけを抽出します。
開始日 = pd.to_datetime("2026-01-01")
終了日 = pd.to_datetime("2026-01-31")

一月注文 = df[df["注文日"].between(開始日, 終了日)]
一月注文
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 0 | 2026-01-03 | ノートPC | PC | 120000.0 |
| 1 | 2026-01-08 | マウス | 周辺機器 | 1000.0 |
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 3 | 2026-01-28 | USBメモリ | 周辺機器 | 980.0 |
このように、between() を使うと、指定期間内の日付データだけを取り出せます。
日付の範囲抽出では、次の流れを意識すると安全です。
pd.to_datetime()で日付型に変換する- 開始日と終了日を決める
between(開始日, 終了日)で抽出する
日付変換そのものを詳しく確認したい場合は、関連記事の to_datetime() を読むと理解しやすくなります。
抽出した結果は、必要な列だけ表示して確認すると見やすくなります。
一月注文[["注文日", "商品", "売上"]]
| 注文日 | 商品 | 売上 | |
|---|---|---|---|
| 0 | 2026-01-03 | ノートPC | 120000.0 |
| 1 | 2026-01-08 | マウス | 1000.0 |
| 2 | 2026-01-15 | キーボード | 4800.0 |
| 3 | 2026-01-28 | USBメモリ | 980.0 |
指定した日付範囲に入る行だけが残っていることを確認できます。
inclusiveで数値や日付の範囲の境界値を含める・含めない設定
between() は、境界値を含めるかどうかを inclusive で指定できます。
たとえば、1000円以上5000円以下なのか、1000円より大きく5000円未満なのかで、結果が変わります。
| 書き方 | 意味 | 境界値1000 | 境界値5000 |
|---|---|---|---|
inclusive="both" |
両端を含む | 含む | 含む |
inclusive="left" |
左だけ含む | 含む | 含まない |
inclusive="right" |
右だけ含む | 含まない | 含む |
inclusive="neither" |
両端を含まない | 含まない | 含まない |
まずは、初期設定と同じ inclusive="both" を確認します。
df[df["売上"].between(1000, 5000, inclusive="both")]
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 1 | 2026-01-08 | マウス | 周辺機器 | 1000.0 |
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 4 | 2026-02-04 | モニター | PC | 5000.0 |
| 6 | NaT | ケーブル | 周辺機器 | 3200.0 |
1000円ちょうど、5000円ちょうどの行がどちらも含まれます。
次に、両端を含めない inclusive="neither" を見てみましょう。
df[df["売上"].between(1000, 5000, inclusive="neither")]
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 6 | NaT | ケーブル | 周辺機器 | 3200.0 |
この場合は、1000円ちょうどと5000円ちょうどの行は含まれません。
初心者がつまずきやすいのは、境界値を含むと思っていたのに含まれていない、またはその逆です。抽出条件を書くときは、「以上・以下」なのか「より大きい・未満」なのかを先に決めておきましょう。
範囲抽出で欠損値があるときの注意点
ここまでで、数値と日付の範囲抽出を確認しました。
次に、抽出対象の列に欠損値がある場合の動きを確認します。
between() では、NaN や日付型の欠損値は範囲内として扱われません。
実際に、売上 が欠損している行がどう判定されるか確認してみましょう。
ここでは、欠損値がどのように判定されるかを見やすくするために、商品・売上・範囲内 だけを並べた確認用のDataFrameを作ります。
元の df を変更しているわけではなく、判定結果を確認するための表です。
pd.DataFrame({
    "商品": df["商品"],
    "売上": df["売上"],
    "範囲内": df["売上"].between(1000, 5000)
})
| 商品 | 売上 | 範囲内 | |
|---|---|---|---|
| 0 | ノートPC | 120000.0 | False |
| 1 | マウス | 1000.0 | True |
| 2 | キーボード | 4800.0 | True |
| 3 | USBメモリ | 980.0 | False |
| 4 | モニター | 5000.0 | True |
| 5 | Webカメラ | NaN | False |
| 6 | ケーブル | 3200.0 | True |
売上 が欠損している行は、範囲内 が False になります。
欠損値は、1000以上とも5000以下とも判断できないためです。欠損値をどう扱うかは、分析目的によって変わります。
between()と>=・<=・query()・cut()の違い
between() と似た処理は、比較演算子や query() でも書けます。また、範囲に関係するメソッドとして cut() もあります。
ここでは、混同しやすい違いだけを整理します。
| 比較対象 | 使う場面 | between()との違い |
|---|---|---|
>=・<= |
同じ範囲抽出を比較演算子で書きたい | between()のほうが範囲抽出の意図が読みやすい |
query() |
同じ範囲抽出を文字列の条件式で書きたい | 条件を文章に近い形で書けるが、列名や文字列条件の書き方に慣れが必要 |
cut() |
数値を区間カテゴリに分けたい | between()は範囲に入る行を抽出、cut()は値を区間に分類 |
同じ範囲条件を、between() と比較演算子で比べてみましょう。
# between()を使う書き方
df[df["売上"].between(1000, 5000)]
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 1 | 2026-01-08 | マウス | 周辺機器 | 1000.0 |
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 4 | 2026-02-04 | モニター | PC | 5000.0 |
| 6 | NaT | ケーブル | 周辺機器 | 3200.0 |
# 比較演算子を使う書き方
df[(df["売上"] >= 1000) & (df["売上"] <= 5000)]
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 1 | 2026-01-08 | マウス | 周辺機器 | 1000.0 |
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 4 | 2026-02-04 | モニター | PC | 5000.0 |
| 6 | NaT | ケーブル | 周辺機器 | 3200.0 |
1つの列を範囲で絞るだけなら、between() のほうが読みやすいことが多いです。
一方で、「売上が5000円以上」「カテゴリが周辺機器」「注文日が1月以降」のように複数条件を組み合わせる場合は、通常の条件式や query() も選択肢になります。
query()で書く場合
同じ条件を query() で書くと、次のようになります。
df.query("1000 <= 売上 <= 5000")
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 1 | 2026-01-08 | マウス | 周辺機器 | 1000.0 |
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 4 | 2026-02-04 | モニター | PC | 5000.0 |
| 6 | NaT | ケーブル | 周辺機器 | 3200.0 |
query() は便利ですが、列名や文字列条件の書き方に慣れが必要です。
この記事では、まず 1つの列を範囲で絞るなら between() と覚えるのがおすすめです。
cut()は抽出ではなく分類に使う
between() と cut() は、どちらも「範囲」に関係しますが、役割は違います。
between() は、範囲に合う行を残すための方法です。
df[df["売上"].between(1000, 5000)]
| 注文日 | 商品 | カテゴリ | 売上 | |
|---|---|---|---|---|
| 1 | 2026-01-08 | マウス | 周辺機器 | 1000.0 |
| 2 | 2026-01-15 | キーボード | 周辺機器 | 4800.0 |
| 4 | 2026-02-04 | モニター | PC | 5000.0 |
| 6 | NaT | ケーブル | 周辺機器 | 3200.0 |
一方で、cut() は値を区間ごとのラベルに分けたいときに使います。ここでは違いを確認するために、軽く例だけ示します。
df["売上帯"] = pd.cut(
    df["売上"],
    bins=[0, 1000, 5000, 200000],
    labels=["低め", "中くらい", "高め"]
)

df[["商品", "売上", "売上帯"]]
| 商品 | 売上 | 売上帯 | |
|---|---|---|---|
| 0 | ノートPC | 120000.0 | 高め |
| 1 | マウス | 1000.0 | 低め |
| 2 | キーボード | 4800.0 | 中くらい |
| 3 | USBメモリ | 980.0 | 低め |
| 4 | モニター | 5000.0 | 中くらい |
| 5 | Webカメラ | NaN | NaN |
| 6 | ケーブル | 3200.0 | 中くらい |
cut() は行を取り出すというより、値をカテゴリに分ける処理です。
今回の記事の主役は、あくまで 範囲で行を抽出する between() です。区間分けを詳しく学びたい場合は、cut() の記事に進むとよいです。
between()を使わない場面も確認しておく
between() は、数値や日付を「下限〜上限」の範囲で絞るときに使います。
一方で、次のような条件では、between() ではなく別のメソッドを使う方が自然です。
| やりたいこと | 使う方法 |
|---|---|
| 候補リストに含まれる値を抽出したい | isin() |
| 文字列を含む行を抽出したい | str.contains() |
たとえば、商品名が「マウス」または「キーボード」の行を取り出したい場合は isin()、商品名に「PC」を含む行を探したい場合は str.contains() が向いています。
この記事では between() を中心に扱うため、isin() と str.contains() は詳しく扱いません。必要に応じて関連記事で確認してください。
抽出したデータを集計して確認する
between() は、抽出して終わりではありません。抽出したデータを集計すると、条件に合うデータの傾向を確認しやすくなります。
データ分析では、必要な行だけを取り出したあとに、件数を数えたり、カテゴリ別に集計したり、グラフにしたりすることが多いです。
ここでは、売上が1000円以上5000円以下の商品だけに絞ったあと、カテゴリ別に件数を数えてみます。
売上範囲内 = df[df["売上"].between(1000, 5000)]

売上範囲内["カテゴリ"].value_counts()
| count | |
|---|---|
| 周辺機器 | 3 |
| PC | 1 |
value_counts() を使うと、抽出後のデータにどのカテゴリが多いかを確認できます。
次に、カテゴリ別の売上合計も確認してみます。
売上範囲内.groupby("カテゴリ")["売上"].sum()
| 売上 | |
|---|---|
| PC | 5000.0 |
| 周辺機器 | 9000.0 |
この流れは、実務でもよく使います。
CSV読み込み → 型確認 → 必要な範囲で抽出 → 集計 → 可視化 という流れの中で、between() は「必要な行だけを取り出す」ための前処理として使えます。
必要に応じてグラフで確認する
集計結果は、必要に応じてグラフで確認できます。
本格的なグラフ調整はMatplotlibの記事で扱うため、ここでは「抽出後のデータを可視化につなげられる」ことだけ確認します。
!pip install japanize-matplotlib > /dev/null

import matplotlib.pyplot as plt
import japanize_matplotlib

集計結果 = 売上範囲内.groupby("カテゴリ")["売上"].sum()

集計結果.plot(kind="bar")
plt.title("カテゴリ別の売上合計")
plt.xlabel("カテゴリ")
plt.ylabel("売上")
plt.show()

between() で絞り込んだあとに集計・可視化すると、必要な範囲だけに注目してデータを見やすくなります。
たとえば、全体では高額商品の影響が大きすぎる場合でも、1000〜5000円の商品だけに絞ることで、中価格帯の商品傾向を確認しやすくなります。
よくあるミスと確認ポイント
between() はシンプルですが、初心者がつまずきやすいポイントがあります。
| よくあるミス | 原因 | 対策 |
|---|---|---|
| 文字列の数字にそのまま使う | 数値として比較できていない | pd.to_numeric() で数値型に変換する |
| 日付文字列にそのまま使う | 日付型ではなく文字列のまま | pd.to_datetime() で日付型に変換する |
| 境界値が思った通りに含まれない | inclusive の指定を確認していない |
以上・以下なのか、より大きい・未満なのかを先に決める |
| 欠損値が抽出されない | NaN や NaT は範囲内にならない |
欠損値処理を先に検討する |
| 複数条件をすべてbetween()で書こうとする | 1つの列の範囲抽出向きのメソッドだから | 複数条件では AND/OR や query() も使う |
数値の範囲抽出では、必要に応じて先に数値型へ変換します。
数値の範囲抽出では、列が文字列になっている場合に pd.to_numeric() で数値型へ変換します。
日付の範囲抽出では、pd.to_datetime() で日付型へ変換してから between() を使います。
between() は、基本的に1つの列を下限〜上限で絞るときに使います。
複数列にまたがる複雑な条件を扱う場合は、通常の条件式や query() も候補にしましょう。
between()は前処理・抽出で使う
between() は、集計や可視化の前に、必要な行だけを取り出すための処理です。
たとえば、次のような流れで使います。
CSV読み込み → 型の確認 → 数値・日付の変換 → 範囲抽出 → 集計 → 可視化
つまり、between() は、すべてのデータを見る前に、分析したい範囲に絞り込むための前処理として使えます。
まとめ:between()は数値・日付の範囲抽出を読みやすくする方法
この記事では、Pandasの between() を使って、数値や日付の範囲で行を抽出する方法を解説しました。
ポイントを整理します。
between()は、1つの列を下限〜上限で絞りたいときに使う- 数値だけでなく、日付の範囲抽出にも使える
- 初期設定では、両端の境界値を含む
- 数値や日付の範囲の境界値を含めるかどうかは
inclusiveで指定できる NaNやNaTは範囲内として扱われない- 文字列の数字は
to_numeric()、日付文字列はto_datetime()で整えてから使う - 候補リストなら
isin()、文字列検索ならstr.contains()、区間分けならcut()を使う - 抽出後は
value_counts()やgroupby()、Matplotlib可視化へつなげると分析に活かしやすい
まずは、「1つの列を下限〜上限で抽出したいときは between()」 と覚えておくと、条件式を読みやすく書けるようになります。
次に読みたい関連記事
範囲抽出の前後で使いやすい記事をまとめます。
pandas 条件抽出(filtering)入門|AND/OR・query関数・複数条件の指定方法
条件抽出全体、AND/OR、query()を整理したいときにおすすめです。Pandas locとilocの違い|行・列の抽出/スライス/条件指定を図解で解説
行・列の指定方法や、条件指定との関係を整理したいときに役立ちます。pandas isinの使い方と仕組み|リスト・複数条件・not isin・処理速度まで徹底解説
候補リストに含まれる行を抽出したいときに参考になります。pandas str.contains()の使い方|文字列を含む行を抽出・na=Falseも解説
文字列を含む行を抽出したいときに使います。pandas to_numeric()の使い方|文字列の数字を数値に変換する方法
文字列の数字を数値に直してから範囲抽出したいときにおすすめです。pandas to_datetime()の使い方|文字列の日付変換とformat・NaT対処を初心者向けに解説
日付の範囲抽出をする前に、日付型への変換を確認したいときに役立ちます。pandas dtの使い方|日付から年・月・曜日を取り出す方法を初心者向けに解説
日付を抽出したあと、年・月・曜日を取り出して集計したいときにおすすめです。pandas cut()の使い方|bins・labelsで数値を区間分けする方法を解説
範囲で抽出するのではなく、価格帯や年代などに分類したいときに使います。Pandas groupby×aggの使い方|基本の集計とaggの書き方を例で解説
範囲抽出したデータをカテゴリ別・月別に集計したいときに役立ちます。pandas value_counts()の使い方|件数集計・割合表示・欠損値の数え方を解説
抽出後の件数を数えたいときにおすすめです。Matplotlib 棒グラフ入門:横棒・グループ化・積み上げまで解説
集計結果を棒グラフで見やすくしたいときに参考になります。
pandasのbetween()は何をするメソッドですか?
between() は、指定した列の値が下限から上限の範囲に入っているかを判定するメソッドです。
たとえば、df["売上"].between(1000, 5000) と書くと、売上 が1000以上5000以下の行を判定できます。その結果を df[...] に入れると、範囲内の行だけを抽出できます。
between()は境界値を含みますか?
初期設定では、境界値を含みます。
つまり、between(1000, 5000) の場合、1000ちょうど、5000ちょうどの値も含まれます。境界値を含めたくない場合は、inclusive="neither" を使います。
between()で日付の範囲抽出はできますか?
できます。
ただし、日付列が文字列のままだと期待どおりに扱えないことがあります。日付の範囲抽出をする前に、pd.to_datetime() で日付型に変換してから between() を使うのがおすすめです。
between()と>=・<=は何が違いますか?
どちらも範囲抽出に使えます。between() は、1つの列を下限〜上限で絞るときに短く読みやすく書けます。
一方、>= や <= は、片側だけの条件や複数条件を細かく組み合わせたいときに便利です。
between()とquery()はどちらを使えばよいですか?
1つの列を単純に範囲で絞るなら、まずは between() がわかりやすいです。
複数条件を文章に近い形で書きたい場合は、query() も便利です。ただし、query() は列名や文字列条件の書き方に少し慣れが必要です。
between()とcut()は何が違いますか?
between() は、範囲に入る行を抽出するために使います。
一方、cut() は、数値を「低価格・中価格・高価格」や「20代・30代・40代」のような区間カテゴリに分けるために使います。抽出したいなら between()、分類したいなら cut() と考えるとわかりやすいです。
範囲抽出で欠損値があるとき、between()はどうなりますか?
NaN や NaT は、範囲内として扱われません。
たとえば、売上が欠損している行や、日付が変換できず NaT になった行は、between() の判定では False になります。
文字列の数字にbetween()を使ってもよいですか?
数値として範囲抽出したい場合は、文字列のまま使わないほうが安全です。
CSVから読み込んだデータでは、数字に見えても文字列になっていることがあります。pd.to_numeric() で数値型に変換してから between() を使うと、意図した範囲抽出になりやすいです。
コメント