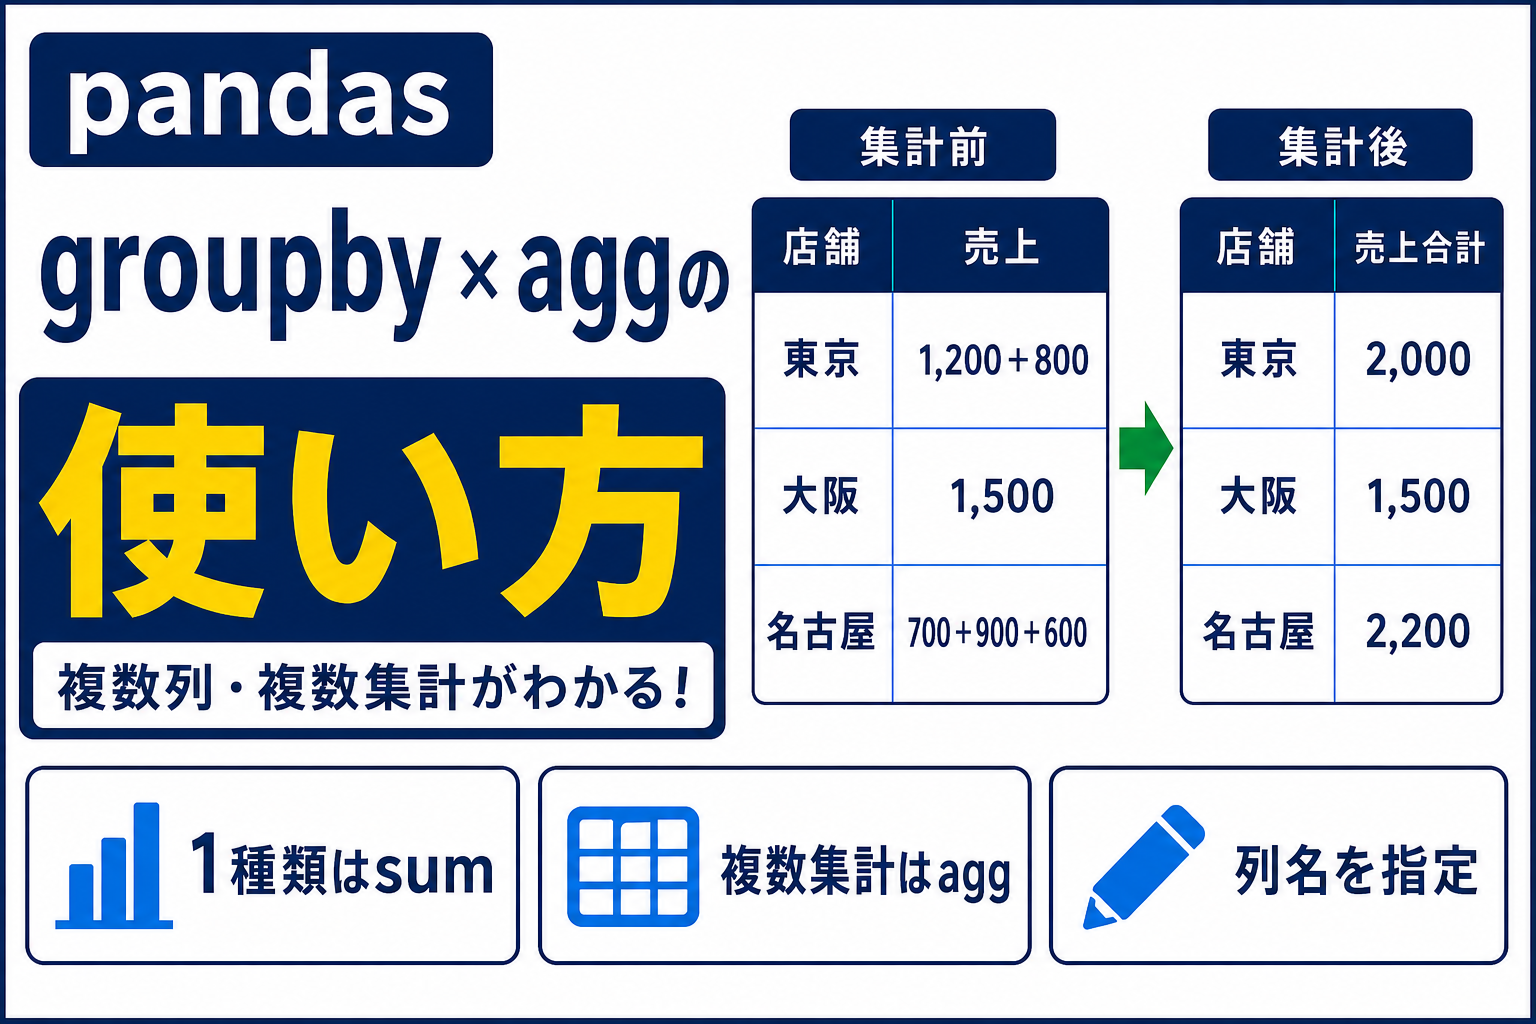
店舗別や商品別に売上をまとめようとして、sum() と agg() のどちらを使えばよいか迷ったことはありませんか。コードは動いても、集計後の列名が2段になったり、明細数が予想より少なかったりすると、結果をどう読めばよいか不安になります。
先に結論を示します。1種類の集計だけなら sum() や mean()、同じ列に複数の集計をするなら agg([...])、列ごとに異なる集計をするなら agg({列名: 集計方法})、結果の列名まで整えたいなら名前付き集約を選びます。
この記事では、同じ売上明細を使って書き方を段階的に変えます。出力の行・列・値を読み、欠損値や表記ゆれによる想定外の結果を確認し、最後は並べ替えや可視化へ使える表に整えます。groupby() は、データ型・欠損・表記を整えた後に比較用の集計表を作る処理です。
この記事でわかること
groupby()とagg()の役割- 専用メソッド・リスト・辞書・名前付き集約の選び方
- 集計結果のグループキー、列名、値の読み方
count()とsize()、as_index=TrueとFalseの違い- 欠損値、データ型、表記ゆれで結果が変わる原因と修正方法
- 元データとの検算から並べ替え・可視化へ進む方法
集計前にデータの構造を確認したい場合は、Pandas DataFrame入門とpandas info()の使い方を参考にしてください。数値型の修正はpandas to_numeric()の使い方、カテゴリの確認はpandas unique()とnunique()の使い方で解説しています。
先に結論:集計の目的で書き方を選ぶ
groupby() は同じ値を持つ行をグループに分け、agg() は各グループに集計関数を適用します。agg() は aggregate() の短い別名で、どちらも同じ処理です。通常は短い agg() がよく使われます。
| 求めたい結果 | 推奨する書き方 | 出力の特徴 | 注意点 |
|---|---|---|---|
| 売上合計など1種類 | groupby(...)[列].sum() |
1つの集計結果 | 単純な目的なら最も読みやすい |
| 同じ列の合計・平均など | .agg(["sum", "mean"]) |
関数名が列になる | 複数列では列名が2段になる |
| 列ごとに異なる集計 | .agg({"売上": "sum", ...}) |
元列と関数の組み合わせ | 複数関数では2段列になりやすい |
| 列名まで指定した集計 | .agg(売上合計=("売上", "sum")) |
1段の分かりやすい列 | 可視化・結合へ渡しやすい |
単純な値別件数は value_counts()、2つのカテゴリの件数・割合は crosstab()、行と列を指定して再配置しながら集計するなら pivot_table() が向いています。選択を誤ると、欲しい数値は得られても、結果の形が次の作業に合わなくなります。
サンプルデータを用意する
店舗ごとの売上を集計します。違いを確認できるように、売上が欠損している行と、店舗名が欠損している行を1つずつ含めます。
import pandas as pd
from IPython.display import display

df = pd.DataFrame({
    "店舗": ["東京", "東京", "大阪", "大阪", "名古屋", "名古屋", "名古屋", None],
    "商品": ["A", "B", "A", "B", "A", "B", "B", "A"],
    "売上": [1200, 800, 1500, None, 700, 900, 600, 500],
    "数量": [2, 1, 3, 2, 1, 2, 1, 1]
})

display(df)| 店舗 | 商品 | 売上 | 数量 | |
|---|---|---|---|---|
| 0 | 東京 | A | 1200.0 | 2 |
| 1 | 東京 | B | 800.0 | 1 |
| 2 | 大阪 | A | 1500.0 | 3 |
| 3 | 大阪 | B | NaN | 2 |
| 4 | 名古屋 | A | 700.0 | 1 |
| 5 | 名古屋 | B | 900.0 | 2 |
| 6 | 名古屋 | B | 600.0 | 1 |
| 7 | None | A | 500.0 | 1 |
実行前の明細は8行です。インデックス3の売上は NaN、インデックス7の店舗も欠損しています。NaN は「0円」ではなく、値が入っていないことを表します。
| インデックス | 店舗 | 商品 | 売上 | 数量 |
|---|---|---|---|---|
| 0 | 東京 | A | 1200 | 2 |
| 1 | 東京 | B | 800 | 1 |
| 2 | 大阪 | A | 1500 | 3 |
| 3 | 大阪 | B | NaN | 2 |
| 4 | 名古屋 | A | 700 | 1 |
| 5 | 名古屋 | B | 900 | 2 |
| 6 | 名古屋 | B | 600 | 1 |
| 7 | NaN | A | 500 | 1 |
自分のデータへ置き換えるときは、まず列名、データ型、欠損数、カテゴリの表記を確認してください。
print(df.dtypes)
print("\n欠損数")
display(df.isna().sum())
print("店舗の値:", df["店舗"].unique())
店舗 object 商品 object 売上 float64 数量 int64 dtype: object 欠損数
| 0 | |
|---|---|
| 店舗 | 1 |
| 商品 | 0 |
| 売上 | 1 |
| 数量 | 0 |
店舗の値: ['東京' '大阪' '名古屋' None]
売上 は欠損値を含むため float64 になります。店舗と売上に各1件の欠損があることも確認できます。ここを見ずに集計すると、行数や合計が予想と違う原因を見落とします。
型の確認はpandas info()の使い方、文字列数値の修正はpandas to_numeric()の使い方、カテゴリ確認はpandas unique()とnunique()の使い方を参考にしてください。
1種類だけ集計するならsum()などの専用メソッド
まず、店舗別の売上合計だけを求めます。集計が1種類なら、agg() を使わず sum() と書く方が目的を読み取りやすくなります。sort=False は、サンプルに最初に現れた店舗順を保つために指定しています。
sales_sum = (
    df.groupby("店舗", sort=False)["売上"]
      .sum()
)
display(sales_sum)| 売上 | |
|---|---|
| 店舗 | |
| 東京 | 2000.0 |
| 大阪 | 1500.0 |
| 名古屋 | 2200.0 |
行インデックスがグループキーの店舗、値が店舗内の売上合計です。東京は 1200 + 800 = 2000、大阪は欠損値を除いた 1500、名古屋は 700 + 900 + 600 = 2200 です。
| 店舗(インデックス) | 売上 |
|---|---|
| 東京 | 2000.0 |
| 大阪 | 1500.0 |
| 名古屋 | 2200.0 |
店舗が欠損した500円の行は、標準の groupby() ではグループに含まれません。この点は後半で確認します。
同じ列へ複数の集計をするならagg()のリスト指定
売上について、合計・平均・有効な値の件数を同時に確認します。集計関数名を文字列のリストで渡します。
sales_stats = (
    df.groupby("店舗", sort=False)["売上"]
      .agg(["sum", "mean", "count"])
)
display(sales_stats.round(1))| sum | mean | count | |
|---|---|---|---|
| 店舗 | |||
| 東京 | 2000.0 | 1000.0 | 2 |
| 大阪 | 1500.0 | 1500.0 | 1 |
| 名古屋 | 2200.0 | 733.3 | 3 |
| 店舗 | sum | mean | count |
|---|---|---|---|
| 東京 | 2000.0 | 1000.0 | 2 |
| 大阪 | 1500.0 | 1500.0 | 1 |
| 名古屋 | 2200.0 | 733.3 | 3 |
sum は合計、mean は欠損値を除いた平均、count は売上に値が入っている件数です。大阪には明細が2行ありますが、売上が有効なのは1行なので count は1です。明細行数を知りたい場合に count() を選ぶと、コードは動いても件数を誤解します。
列ごとに異なる集計をするならagg()の辞書指定
売上には合計と平均、数量には合計と最大値を使います。対象列ごとに処理が違う場合は、列名: 集計方法 の辞書で指定します。
stats_by_column = (
    df.groupby("店舗", sort=False)
      .agg({
          "売上": ["sum", "mean"],
          "数量": ["sum", "max"]
      })
)
display(stats_by_column.round(1))| 売上 | 数量 | |||
|---|---|---|---|---|
| sum | mean | sum | max | |
| 店舗 | ||||
| 東京 | 2000.0 | 1000.0 | 3 | 2 |
| 大阪 | 1500.0 | 1500.0 | 5 | 3 |
| 名古屋 | 2200.0 | 733.3 | 4 | 2 |
この出力では列が2段になります。上段の 売上・数量 が元の列、下段の sum・mean・max が適用した関数です。たとえば名古屋の (売上, mean) は733.3、(数量, max) は2です。
| 店舗 | 売上 sum | 売上 mean | 数量 sum | 数量 max |
|---|---|---|---|---|
| 東京 | 2000.0 | 1000.0 | 3 | 2 |
| 大阪 | 1500.0 | 1500.0 | 5 | 3 |
| 名古屋 | 2200.0 | 733.3 | 4 | 2 |
二段列は情報を正確に表しますが、列名を指定する可視化や結合では扱いにくいことがあります。その場合は、次の名前付き集約を選びます。
名前付き集約で分かりやすい1段の列にする
名前付き集約では、出力列名=(元の列名, 集計方法) と指定します。as_index=False も使い、店舗をインデックスではなく通常の列として残します。次の可視化・並べ替え・結合へ渡しやすい形です。
summary = (
    df.groupby("店舗", as_index=False, sort=False)
      .agg(
          売上合計=("売上", "sum"),
          平均売上=("売上", "mean"),
          有効売上件数=("売上", "count"),
          明細行数=("売上", "size"),
          商品種類数=("商品", "nunique")
      )
)
summary["平均売上"] = summary["平均売上"].round(1)
display(summary)| 店舗 | 売上合計 | 平均売上 | 有効売上件数 | 明細行数 | 商品種類数 | |
|---|---|---|---|---|---|---|
| 0 | 東京 | 2000.0 | 1000.0 | 2 | 2 | 2 |
| 1 | 大阪 | 1500.0 | 1500.0 | 1 | 2 | 2 |
| 2 | 名古屋 | 2200.0 | 733.3 | 3 | 3 | 2 |
| 店舗 | 売上合計 | 平均売上 | 有効売上件数 | 明細行数 | 商品種類数 |
|---|---|---|---|---|---|
| 東京 | 2000.0 | 1000.0 | 2 | 2 | 2 |
| 大阪 | 1500.0 | 1500.0 | 1 | 2 | 2 |
| 名古屋 | 2200.0 | 733.3 | 3 | 3 | 2 |
処理前は店舗ごとの明細が複数行ありましたが、処理後は1店舗1行になりました。大阪では 有効売上件数=1、明細行数=2 なので、2件の明細のうち売上が欠損した行が1件あると判断できます。
as_index=TrueとFalseの違い
| 設定 | グループキーの位置 | 選ぶ場面 |
|---|---|---|
標準の as_index=True |
インデックス | 集計結果をそのまま参照するとき |
as_index=False |
通常の列 | 可視化・結合・CSV保存へ使うとき |
標準設定で集計した後に通常の列へ戻すなら、reset_index() も使えます。
インデックスを通常の列へ戻す方法は、pandas reset_index()の使い方で詳しく解説しています。
count()とsize()は欠損値の扱いが違う
count() は指定列の欠損値を数えず、size() はグループ内の行そのものを数えます。大阪のように売上が欠損した行があると差が生まれます。
count_size = (
    df.groupby("店舗", sort=False)
      .agg(
          売上の有効値数=("売上", "count"),
          明細行数=("売上", "size")
      )
)
display(count_size)| 売上の有効値数 | 明細行数 | |
|---|---|---|
| 店舗 | ||
| 東京 | 2 | 2 |
| 大阪 | 1 | 2 |
| 名古屋 | 3 | 3 |
| 店舗 | 売上の有効値数(count) | 明細行数(size) |
|---|---|---|
| 東京 | 2 | 2 |
| 大阪 | 1 | 2 |
| 名古屋 | 3 | 3 |
売上が記録された件数なら count()、欠損を含む明細の行数なら size() を選びます。差が想定外なら、売上列の欠損数を確認してください。
コードは動くが結果を誤解しやすい場面
欠損したグループキーが結果から消える
現象: 元データの売上合計は6200なのに、店舗別売上の合計は5700になります。
原因: groupby() は標準で、グループキーが欠損した行を結果に含めません。
確認方法: 元合計、店舗が欠損していない行の合計、集計後合計を比べます。
source_total = df["売上"].sum()
eligible_total = df.loc[df["店舗"].notna(), "売上"].sum()
grouped_total = summary["売上合計"].sum()

print("元データ全体の売上合計:", source_total)
print("店舗名がある行の売上合計:", eligible_total)
print("店舗別集計後の売上合計:", grouped_total)
元データ全体の売上合計: 6200.0 店舗名がある行の売上合計: 5700.0 店舗別集計後の売上合計: 5700.0
出力は順に 6200.0、5700.0、5700.0 です。集計計算が間違ったのではなく、店舗が欠損した500円が標準設定の対象外です。
修正方法: 欠損した店舗も確認対象なら dropna=False を指定します。修正後は欠損店舗の500円が別グループとして現れ、集計後合計が6200になります。欠損店舗を業務上の「不明」として補完するか、除外するかは分析目的に応じて決めてください。
summary_with_missing = (
    df.groupby("店舗", dropna=False, as_index=False, sort=False)
      .agg(売上合計=("売上", "sum"))
)
display(summary_with_missing)
print("集計後合計:", summary_with_missing["売上合計"].sum())| 店舗 | 売上合計 | |
|---|---|---|
| 0 | 東京 | 2000.0 |
| 1 | 大阪 | 1500.0 |
| 2 | 名古屋 | 2200.0 |
| 3 | NaN | 500.0 |
集計後合計: 6200.0
文字列数値で集計結果やエラーが想定と違う
現象: 数値のつもりの列が文字列で、集計できない、または期待しない結果になります。
原因: CSVやExcelから読み込んだ列に、カンマや通貨記号などが混ざっている可能性があります。
確認方法: df.dtypes または df.info() で集計対象列の型を確認します。
修正方法: 不要な記号を除いたうえで pd.to_numeric(..., errors="coerce") を使い、変換できなかった行が新しい欠損値になっていないか確認します。意味のある文字列を無条件に欠損へ変えてはいけません。
表記ゆれで同じ店舗が別グループになる
現象: 「東京」と「東京 」が別の行に集計されます。
原因: 末尾の空白など、見た目で気づきにくい文字の違いがあります。
確認方法: unique() でグループキーの値を確認します。
修正方法: 意味を確認してから str.strip() や replace() で表記をそろえ、再度 unique() と集計結果のグループ数を確認します。
前後の空白を除く方法はpandas str.strip()の使い方、値の表記を置き換える方法はpandas replace()の使い方を参考にしてください。
groupby().agg()と近い手法の選び方
| 手法 | 何を求めるか | 選ぶ場面 | 選択を誤った場合 |
|---|---|---|---|
groupby().agg() |
グループ別の複数集計 | 店舗別に売上合計・平均・件数をまとめる | 単純件数には記述が長くなる |
DataFrame.agg() |
DataFrame全体の列・行方向の集約 | グループ分けせず列ごとの統計量を出す | 店舗別などの区分は得られない |
value_counts() |
1列の値別件数 | 商品A・Bが何件あるか数える | 売上合計など複数指標には向かない |
crosstab() |
2カテゴリの組み合わせの件数・割合 | 店舗×商品の件数表を作る | 数値列の柔軟な複数集計には向かない |
pivot_table() |
行・列へ配置した集計表 | 店舗を行、商品を列にして売上を比較する | 単純な縦長集計には形が複雑になる |
apply() や transform() はより自由なグループ処理に使えますが、単純な集計を行うこの記事では深入りしません。まずは目的が明確で読みやすい専用メソッドや agg() を選びましょう。
単純な件数確認はpandas value_counts()の使い方、2列のクロス集計はpandas crosstab()の使い方、表の再配置を伴う集計はPandas pivotとpivot_tableの違い、日時単位の集計はpandas resample()の使い方を参考にしてください。
集計結果を次の分析へつなげる
名前付き集約で作った summary は、店舗が通常の列で、集計列も1段です。そのまま売上合計順に並べ替えられます。
summary_sorted = summary.sort_values("売上合計", ascending=False)
display(summary_sorted)| 店舗 | 売上合計 | 平均売上 | 有効売上件数 | 明細行数 | 商品種類数 | |
|---|---|---|---|---|---|---|
| 2 | 名古屋 | 2200.0 | 733.3 | 3 | 3 | 2 |
| 0 | 東京 | 2000.0 | 1000.0 | 2 | 2 | 2 |
| 1 | 大阪 | 1500.0 | 1500.0 | 1 | 2 | 2 |
売上合計は名古屋2200、東京2000、大阪1500の順です。次は棒グラフにすると、店舗間の差を視覚的に比較できます。ここでは集計が主題なので、グラフ作成は最小限の例にとどめます。
!pip install japanize-matplotlib > /dev/null # Google Colab の機能を使って日本語フォントをインストール・インポート
import japanize_matplotlib

import matplotlib.pyplot as plt

ax = summary_sorted.plot.bar(
    x="店舗",
    y="売上合計",
    legend=False,
    color="steelblue",
    figsize=(7, 4)
)
ax.set_title("店舗別の売上合計")
ax.set_xlabel("店舗")
ax.set_ylabel("売上合計")
plt.xticks(rotation=0)
plt.tight_layout()
plt.show()
Google Colabで日本語が四角形になる場合は、日本語フォントの設定が必要です。グラフの作り方はMatplotlib棒グラフ入門で確認してください。横持ちの比較表へ変える場合はPandas pivotとpivot_tableの違い、順位付けはpandas 並び替え(sort)入門へ進むと自然です。
自分のデータへ置き換える前のチェックリスト
- グループキーと集計対象の列名は正しいか
- 列名の前後に空白がないか
- 売上・数量などが数値型になっているか
- グループキーと集計対象列に欠損値が何件あるか
- カテゴリに全角・半角、前後空白などの表記ゆれがないか
- 元データの1行が明細、顧客、日など何を表すか
sum・mean・count・sizeが知りたい指標と合っているか- 出力を可視化・結合するなら、列名とインデックスの形が使いやすいか
- 集計対象をそろえたうえで、元データと集計後の合計が一致するか
まとめ
- 1種類の集計だけなら
sum()やmean()などの専用メソッドを選ぶ - 同じ列に複数関数ならリスト、列ごとに異なる関数なら辞書を
agg()へ渡す - 次の分析へ使いやすい列名が必要なら名前付き集約を選ぶ
as_index=Falseまたはreset_index()でグループキーを通常列にできるcount()は有効値、size()は欠損を含む行数を数える- 欠損キー、データ型、表記ゆれを確認し、同じ対象範囲で元合計と照合する
groupby().agg() のゴールは、コードを動かすことではありません。集計目的に合う書き方を選び、結果を説明できる状態にして、並べ替え・ピボット・可視化へ進めることです。
関連記事
今回の集計前後で役立つ関連記事をまとめます。
- Pandas DataFrame入門|作り方と基本操作を初心者向けに解説
- pandas info()の使い方|Non-Null Count・データ型・欠損値の見方
- pandas to_numeric()の使い方|文字列の数字を数値に変換する方法
- pandas unique()とnunique()の使い方|値の一覧・種類数・value_counts()との違い
- pandas value_counts()の使い方|件数集計・割合表示・欠損値の数え方
- pandas crosstab()の使い方|2つの列をクロス集計・割合表示する方法
- Pandas pivotとpivot_tableの違い|重複データ対応と集計方法
- pandas reset_index()の使い方|インデックスを振り直す方法
- pandas 並び替え(sort)入門|sort_values・sort_indexの違い
- Matplotlib 棒グラフ入門|横棒・グループ化・積み上げまで解説
groupby().agg()とDataFrame.agg()の違いは何ですか?
groupby().agg() は店舗別などのグループごとに集計します。DataFrame.agg() はグループ分けをせず、DataFrameの列または行へ集計関数を適用します。
agg()とaggregate()は同じですか?
はい。agg() は aggregate() の別名です。通常は短い agg() がよく使われます
複数列に別々の集計関数を使うにはどうしますか?
agg({"売上": "sum", "数量": "mean"}) のように辞書で指定します。出力列名も決めたい場合は、売上合計=("売上", "sum") のような名前付き集約が便利です。
集計後の列名が二段になるのはなぜですか?
複数列へ複数関数を適用すると、元の列名と集計関数名を両方表すため列がMultiIndexになります。次工程で1段列が必要なら、名前付き集約を使います。
グループキーを通常の列にするにはどうしますか?
groupby(..., as_index=False) を使うか、集計後に reset_index() を実行します。
count()とsize()で件数が違うのはなぜですか?
count() は対象列の欠損値を数えず、size() はグループの行数を数えるためです。有効な売上件数には count()、欠損を含む明細数には size() を選びます。
NaNのグループが結果から消れるのはなぜですか?
groupby() は標準でグループキーが欠損した行を除くためです。欠損キーも表示して確認するなら dropna=False を指定します。
同じカテゴリが別グループになるのはなぜですか?
前後空白、全角・半角、大文字・小文字などの表記が異なる可能性があります。unique() で実際の値を確認し、意味を確かめてから str.strip() や replace() でそろえます。
コメント