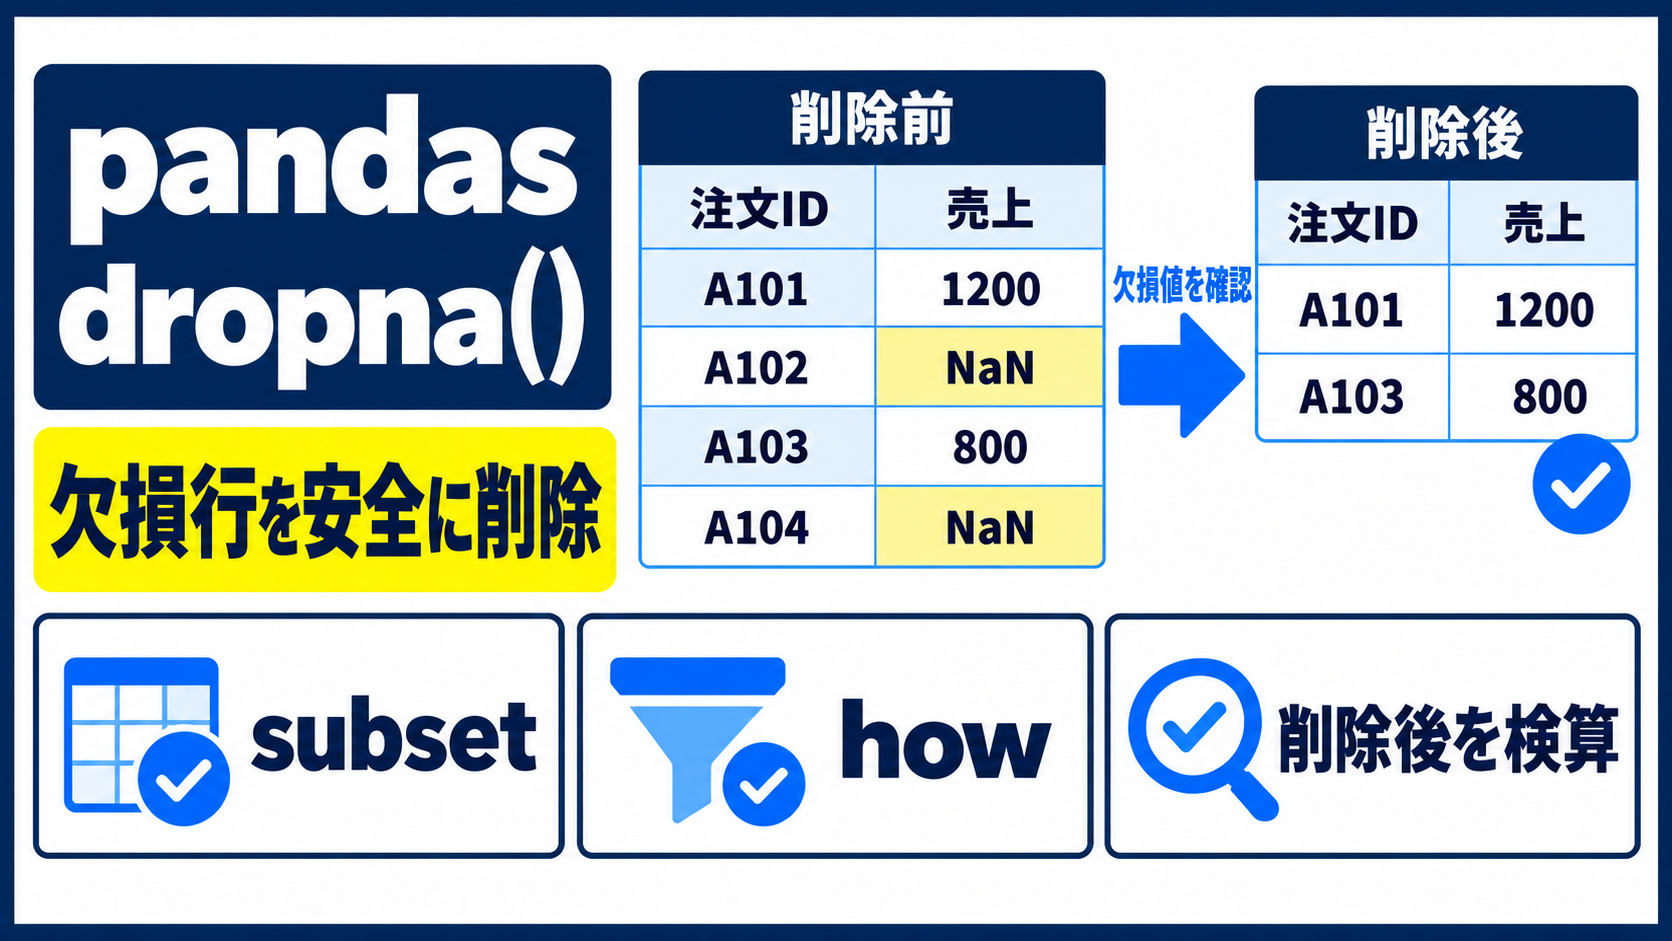
pandasでCSVやExcelを読み込んだあと、dropna()を実行したら、予想以上に行が減って困ったことはありませんか。
dropna()は欠損値の意味を判断してくれるメソッドではありません。引数を指定しない場合は、どれか1列でも欠損している行を削除します。そのため、売上分析には必要な行が、任意項目の未入力だけで消えることがあります。
先に結論を示すと、次の順番で使うのが安全です。
- 欠損値の場所・件数・対象行を確認する
- 分析に必須の列を決める
- 通常は
subsetで削除の判定列を絞る - 削除後の行数・欠損数・残ったIDを検算する
この記事では、注文データを使い、Google Colabで欠損行の確認から削除、検算、次の集計までを順番に実行します。最後には、「なぜこの行を削除したのか」を自分のデータで説明できる状態を目指します。
- この記事でわかること
- 先に結論:全列ではなく「分析に必須の列」で削除を判断する
- 注文データを用意して、削除前の状態を確認する
- 引数なしのdropna()では必要な行まで削除される
- subsetで削除の基準にする列を絞る
- 削除前後は行数・欠損数・残ったIDを検算する
- how・thresh・axisは目的が合う場合だけ使う
- 元のDataFrameへの反映とignore_indexの選び方
- 空文字列がdropna()で消えないときは表記を確認する
- dropna()とfillna()は「行を失ってよいか」で選ぶ
- よくある失敗を現象から確認・修正する
- 自分のDataFrameへ置き換える前のチェックリスト
- 欠損値を削除したデータを集計へつなげる
- まとめ
- 関連記事
この記事でわかること
dropna()の既定動作と、必要な行まで消える理由subset・how・thresh・axisの選び方howとthreshを同時に指定できない理由- 削除前後の行数・欠損数・注文IDを確認する方法
- 元のDataFrameへ反映する方法と
ignore_index=Trueの注意点 - 空文字列が削除されないときの確認方法
dropna()とfillna()の使い分け
dropna()は、データを読み込んで状態を確認したあと、集計や可視化へ進む前に行う前処理の一つです。前処理全体の順番を先に知りたい場合は、Pandasデータ前処理の基本も参考にしてください。
先に結論:全列ではなく「分析に必須の列」で削除を判断する
引数なしのdf.dropna()は、1つでも欠損値がある行を削除します。しかし、任意入力の「地域」が空でも、金額が分かれば売上集計に使える場合があります。
最初に、目的に合う指定を選びましょう。
| 目的 | 選ぶ指定 | 削除される条件 | 残り得る欠損 | 注意点 |
|---|---|---|---|---|
| どの列にも欠損がない行だけ残す | 引数なし | 1列でも欠損 | なし | 必要な行まで消えやすい |
| 必須列が欠損した行だけ削除 | subset |
指定列が欠損 | 指定外の列 | 実務ではまず検討する |
| 全項目が欠損した行だけ削除 | how='all' |
すべての列が欠損 | 一部の欠損 | 空の追加行などに使う |
| 有効な値が少なすぎる行を削除 | thresh |
非欠損値が指定数未満 | 条件内の欠損 | 「欠損数」ではなく「非欠損数」 |
| 欠損を含む列を削除 | axis=1 |
列に欠損がある | 残った列にはなし | 列全体が消えるため慎重に使う |
欠損行を残す必要がある場合は、削除せずfillna()で補完する選択肢があります。削除と補完の違いは後半で比較します。
注文データを用意して、削除前の状態を確認する
実行目的
注文ID・顧客ID・商品・金額・地域を持つDataFrameを作り、どの列と行に欠損があるか確認します。金額は売上集計の必須列、地域と顧客IDは今回の集計では任意列とします。
np.nanとNoneはpandasが欠損値として認識します。一方、A106の地域に入れた空文字列''は欠損値として認識されません。この違いも後で確認します。
import pandas as pd
import numpy as np

df = pd.DataFrame({
    "order_id": ["A101", "A102", "A103", "A104", "A105", "A106", "A107", "A108"],
    "customer_id": ["C01", "C02", "C03", "C04", "C05", "C06", None, "C08"],
    "product": ["PC", "Chair", "PC", "Chair", "Monitor", "PC", "Chair", "Monitor"],
    "amount": [12000, 8000, np.nan, 5000, 15000, 9000, 7000, np.nan],
    "region": ["関東", "関西", "関東", None, "中部", "", "関西", "関東"],
})

print(df.to_string(index=True))| order_id | customer_id | product | amount | region | |
|---|---|---|---|---|---|
| 0 | A101 | C01 | PC | 12000.0 | 関東 |
| 1 | A102 | C02 | Chair | 8000.0 | 関西 |
| 2 | A103 | C03 | PC | NaN | 関東 |
| 3 | A104 | C04 | Chair | 5000.0 | None |
| 4 | A105 | C05 | Monitor | 15000.0 | 中部 |
| 5 | A106 | C06 | PC | 9000.0 | |
| 6 | A107 | None | Chair | 7000.0 | 関西 |
| 7 | A108 | C08 | Monitor | NaN | 関東 |
出力では、A103・A108のamount、A104のregion、A107のcustomer_idが欠損しています。A106のregionは見た目が空でも空文字列なので、NaNとは表示されません。
次に、列ごとの欠損数と、欠損を1つでも含む行を確認します。削除前に対象行を表示しておくと、必要な注文まで消していないか判断できます。欠損値の確認方法を詳しく知りたい場合は、pandasで欠損値を確認する方法を参照してください。
print("列ごとの欠損数")
print(df.isna().sum().to_string())

print("\n欠損を1つでも含む行")
missing_rows = df[df.isna().any(axis=1)]
print(missing_rows.to_string(index=False))| 欠損数 | |
|---|---|
| order_id | 0 |
| customer_id | 1 |
| product | 0 |
| amount | 2 |
| region | 1 |
| order_id | customer_id | product | amount | region | |
|---|---|---|---|---|---|
| 2 | A103 | C03 | PC | NaN | 関東 |
| 3 | A104 | C04 | Chair | 5000.0 | None |
| 6 | A107 | None | Chair | 7000.0 | 関西 |
| 7 | A108 | C08 | Monitor | NaN | 関東 |
注目するのは、amountの欠損が2件であることと、欠損を含む注文IDがA103・A104・A107・A108であることです。
ただし、4件すべてを削除する必要はありません。今回の売上集計に必須なのはamountなので、削除候補はA103・A108の2件です。A104は地域が未入力、A107は顧客IDが未入力ですが、金額と商品があるため商品別売上には使えます。
引数なしのdropna()では必要な行まで削除される
実行目的
まず既定動作を確認します。引数なしでは、すべての列が判定対象です。
df_default = df.dropna()

print(df_default.to_string(index=False))
print(f"\n処理前: {len(df)}行")
print(f"処理後: {len(df_default)}行")
print("削除された注文ID:", sorted(set(df["order_id"]) - set(df_default["order_id"])))| order_id | customer_id | product | amount | region | |
|---|---|---|---|---|---|
| 0 | A101 | C01 | PC | 12000.0 | 関東 |
| 1 | A102 | C02 | Chair | 8000.0 | 関西 |
| 4 | A105 | C05 | Monitor | 15000.0 | 中部 |
| 5 | A106 | C06 | PC | 9000.0 |
処理前: 8行
処理後: 4行
削除された注文ID: ['A103', 'A104', 'A107', 'A108']
処理後は8行から4行に減り、A103・A104・A107・A108が削除されました。A104とA107は金額があるため、商品別売上には利用できる行です。それでも消えたのは、dropna()が分析目的を知らず、全列の欠損を同じように判定するからです。
また、地域が空文字列のA106は残っています。コードが正常終了し、欠損行を削除できても、削除条件が分析目的に合っているとは限りません。
subsetで削除の基準にする列を絞る
実行目的
商品別売上に必須のamountだけを判定対象にします。subsetへ指定していない列に欠損があっても、その行は削除されません。
df_amount = df.dropna(subset=["amount"])

print(df_amount.to_string(index=False))
print(f"\n処理前: {len(df)}行")
print(f"処理後: {len(df_amount)}行")
print("削除された注文ID:", sorted(set(df["order_id"]) - set(df_amount["order_id"])))| order_id | customer_id | product | amount | region | |
|---|---|---|---|---|---|
| 0 | A101 | C01 | PC | 12000.0 | 関東 |
| 1 | A102 | C02 | Chair | 8000.0 | 関西 |
| 3 | A104 | C04 | Chair | 5000.0 | None |
| 4 | A105 | C05 | Monitor | 15000.0 | 中部 |
| 5 | A106 | C06 | PC | 9000.0 | |
| 6 | A107 | None | Chair | 7000.0 | 関西 |
処理前: 8行
処理後: 6行
削除された注文ID: ['A103', 'A108']
今度はA103・A108だけが削除され、8行から6行になりました。A104のregionとA107のcustomer_idには欠損が残っていますが、これは失敗ではありません。subset=['amount']は、金額が欠損した行だけを削除する指定だからです。
複数の必須列を基準にする場合は、subsetへ列名を複数指定します。たとえば、商品名と金額の両方が必要ならproductとamountを判定対象にします。列名を間違えるとKeyErrorになるため、自分のデータでは実際の列名を確認してください。
削除前後は行数・欠損数・残ったIDを検算する
dropna()の結果は、DataFrameを眺めるだけでなく、同じ基準で数値確認します。
| 確認項目 | 処理前 | subset=['amount']で処理後 |
読み方 |
|---|---|---|---|
| 行数 | 8 | 6 | 金額欠損2件だけ減った |
amountの欠損数 |
2 | 0 | 必須列の欠損は解消した |
| 残った注文ID | A101〜A108 | A101・A102・A104・A105・A106・A107 | A103・A108だけ削除した |
regionの欠損数 |
1 | 1 | subset外なので残ってよい |
customer_idの欠損数 |
1 | 1 | 今回の集計では任意列 |
次のコードで、削除件数と必須列の欠損数を機械的に確認します。
removed_ids = sorted(set(df["order_id"]) - set(df_amount["order_id"]))

check = pd.Series({
    "処理前の行数": len(df),
    "処理後の行数": len(df_amount),
    "削除行数": len(df) - len(df_amount),
    "処理後のamount欠損数": int(df_amount["amount"].isna().sum()),
    "処理後のregion欠損数": int(df_amount["region"].isna().sum()),
})

print(check.to_string())
print("削除された注文ID:", removed_ids)| 値 | |
|---|---|
| 処理前の行数 | 8 |
| 処理後の行数 | 6 |
| 削除行数 | 2 |
| 処理後のamount欠損数 | 0 |
| 処理後のregion欠損数 | 1 |
削除された注文ID: ['A103', 'A108']
「削除行数が2」「処理後のamount欠損数が0」「削除IDがA103・A108」の3点が一致しています。regionの欠損が1件残るのは、今回の目的では許容した結果です。
実データでは、削除候補が特定の地域・顧客層・期間へ偏っていないかも確認してください。偏った欠損行をまとめて削除すると、コードは正しくても集計結果が実態からずれる可能性があります。
how・thresh・axisは目的が合う場合だけ使う
how=’all’:すべて欠損した行だけを削除する
how='all'は、全項目が欠損している行だけを削除します。CSVの末尾に空行相当のレコードが入った場合などに使えます。一部に値がある行は残ります。
empty_row = pd.DataFrame([{
    "order_id": None,
    "customer_id": None,
    "product": None,
    "amount": np.nan,
    "region": None,
}])

df_with_empty_row = pd.concat([df, empty_row], ignore_index=True)
df_how_all = df_with_empty_row.dropna(how="all")

print(f"処理前: {len(df_with_empty_row)}行")
print(f"処理後: {len(df_how_all)}行")
print(df_how_all.tail(3).to_string(index=False))
処理前: 9行 処理後: 8行
| order_id | customer_id | product | amount | region | |
|---|---|---|---|---|---|
| 5 | A106 | C06 | PC | 9000.0 | |
| 6 | A107 | None | Chair | 7000.0 | 関西 |
| 7 | A108 | C08 | Monitor | NaN | 関東 |
9行目の全項目が欠損した行だけが削除され、元の8行は残ります。how='any'は欠損が1つでもあれば削除、how='all'はすべて欠損した場合だけ削除、と読み分けます。
thresh:非欠損値が一定数以上ある行を残す
thresh=4は「欠損が4個まで」という意味ではありません。欠損していない値が4個以上ある行を残す指定です。5列のうち2列しか値がない疎な行を追加して確認します。
sparse_row = pd.DataFrame([{
    "order_id": "A109",
    "customer_id": None,
    "product": "PC",
    "amount": np.nan,
    "region": None,
}])

df_with_sparse_row = pd.concat([df, sparse_row], ignore_index=True)
df_thresh = df_with_sparse_row.dropna(thresh=4)

print("A109の非欠損値数:", int(df_with_sparse_row.iloc[-1].notna().sum()))
print("thresh=4の処理後にA109があるか:", "A109" in df_thresh["order_id"].values)
print("残った注文ID:", df_thresh["order_id"].tolist())
A109の非欠損値数: 2 thresh=4の処理後にA109があるか: False 残った注文ID: ['A101', 'A102', 'A103', 'A104', 'A105', 'A106', 'A107', 'A108']
A109の非欠損値はorder_idとproductの2個だけなので、thresh=4では削除されます。
howとthreshは同時に指定できません。 「欠損が1つでもあるか・すべて欠損か」で選ぶならhow、「有効な値が何個以上あるか」で選ぶならthreshを使い、どちらか一方だけを指定してください。
axis=1:欠損を含む列を削除する
axis=1は行ではなく列を削除します。今回のデータに引数なしの条件を適用すると、欠損が1つでもあるcustomer_id・amount・regionが列ごと消えます。
df_drop_columns = df.dropna(axis=1)

print("処理前の列:", df.columns.tolist())
print("処理後の列:", df_drop_columns.columns.tolist())
print(df_drop_columns.head(3).to_string(index=False))
処理前の列: ['order_id', 'customer_id', 'product', 'amount', 'region'] 処理後の列: ['order_id', 'product']
| order_id | product | |
|---|---|---|
| 0 | A101 | PC |
| 1 | A102 | Chair |
| 2 | A103 | PC |
残るのは欠損のないorder_idとproductだけです。金額列まで失うため、今回の売上分析には使えません。列削除は、列自体が不要であると確認できた場合に限定しましょう。
元のDataFrameへの反映とignore_indexの選び方
dropna()は既定では新しいDataFrameを返し、元のdfを変更しません。処理前後を比べやすくするには、まずdf_amountのような別変数へ保存する方法が安全です。同じ変数へ反映するなら、df = df.dropna(...)のように再代入します。
inplace=Trueでも元のDataFrameを直接変更できますが、戻り値はNoneです。初心者のうちは、処理前後を確認できるように別変数または再代入を使うと、意図しない削除へ気づきやすくなります。
削除後のインデックスを0から振り直したい場合は、pandas 2.0.0以降ではignore_index=Trueを指定できます。古い環境でこの引数が使えない場合は、dropna()の結果へreset_index(drop=True)を続けます。
df_amount_reset = df.dropna(subset=["amount"], ignore_index=True)

print(df_amount_reset.to_string(index=True))| order_id | customer_id | product | amount | region | |
|---|---|---|---|---|---|
| 0 | A101 | C01 | PC | 12000.0 | 関東 |
| 1 | A102 | C02 | Chair | 8000.0 | 関西 |
| 2 | A104 | C04 | Chair | 5000.0 | None |
| 3 | A105 | C05 | Monitor | 15000.0 | 中部 |
| 4 | A106 | C06 | PC | 9000.0 | |
| 5 | A107 | None | Chair | 7000.0 | 関西 |
インデックスは0〜5の連番になりました。一方、元の行ラベルは失われます。注文の識別にはorder_idを使い、インデックスを注文IDだと誤解しないでください。
元のインデックスを残しておきたい場合はignore_index=Trueを指定しません。インデックスを列として残したい、列名を付けて整理したい場合は、pandas reset_index()の使い方も確認してください。
空文字列がdropna()で消えないときは表記を確認する
起きる現象
欠損行を削除したのに、A106のregionのような空欄が残ります。
原因
空文字列''は文字列であり、pandasの欠損値ではありません。前後に空白だけが入った文字列も、そのままでは欠損値として数えられません。
確認方法と修正方法
文字列の前後空白を除き、空文字列を欠損値へ統一してからdropna()を使います。元のDataFrameを壊さないようにコピーして確認します。
df_normalized = df.copy()
df_normalized["region"] = df_normalized["region"].str.strip().replace("", pd.NA)

print("修正前のregion欠損数:", int(df["region"].isna().sum()))
print("修正後のregion欠損数:", int(df_normalized["region"].isna().sum()))
print("修正後にregionが欠損している注文ID:",
      df_normalized.loc[df_normalized["region"].isna(), "order_id"].tolist())
修正前のregion欠損数: 1 修正後のregion欠損数: 2 修正後にregionが欠損している注文ID: ['A104', 'A106']
修正前はA104の1件だけでしたが、修正後はA104とA106の2件が欠損として確認できます。その後に地域を必須列として削除するか、「不明」として補完するかを分析目的から選びます。
実データでは空文字列のほか、'-'・'不明'・'N/A'など独自の欠損表記が混ざることがあります。それらを機械的に欠損へ変換する前に、業務上の意味を確認してください。前後空白の削除方法はpandas str.strip()の使い方で詳しく確認できます。
dropna()とfillna()は「行を失ってよいか」で選ぶ
| 判断すること | dropna()を選ぶ場面 | fillna()を選ぶ場面 |
|---|---|---|
| 行を失ってよいか | 必須値がなく分析に使えない | 行自体は残す必要がある |
| 欠損の意味 | 記録不成立・対象外と判断できる | 未回答・未測定など意味がある |
| 集計への影響 | 母数や対象件数が減る | 補完値によって平均などが変わる |
| 実行後の確認 | 削除件数・残存ID・偏り | 補完件数・補完値・分布の変化 |
今回のamount欠損は、売上金額を集計できないため削除対象としました。一方、regionが未入力でも全国の売上合計には使えるため、行を残しました。
0や平均値で埋めると行数は保てますが、「売上不明」を「売上0」とみなすなど、意味が変わる可能性があります。補完方法の選び方は、pandas fillna()の使い方で確認してください。
よくある失敗を現象から確認・修正する
行が想定以上に減った
- 原因:引数なしで全列を判定対象にした可能性がある
- 確認方法:列別の欠損数と、
df[df.isna().any(axis=1)]で削除候補を確認する - 修正方法:分析に必須の列だけを
subsetへ指定する - 修正後の確認:削除行数、必須列の欠損数、残ったIDが想定と一致するか確認する
dropna()を書いたのに元のdfが変わらない
- 原因:既定では新しいDataFrameを返し、元の
dfは変更しない - 確認方法:結果を変数へ代入しているか確認する
- 修正方法:
df_clean = df.dropna(...)またはdf = df.dropna(...)の形で保存する - 修正後の確認:保存先のDataFrameの行数と欠損数を確認する
subsetでKeyErrorが出た
- 原因:指定した列名が存在しない、または列名に前後空白・表記違いがある
- 確認方法:
df.columnsで実際の列名を確認する - 修正方法:存在する列名へ直し、必要なら列名の前後空白を除く
- 修正後の確認:指定列だけを基準に、想定した行が削除されたか確認する
howとthreshを一緒に指定してエラーになった
- 原因:現在のpandasでは
howとthreshを同時に使えない - 確認方法:「欠損の有無」と「非欠損値数」のどちらで判定したいか確認する
- 修正方法:目的に合う片方だけを指定する
- 修正後の確認:残った行の非欠損値数または欠損状態を確認する
空欄が残った
- 原因:空文字列や空白だけの文字列は欠損値として認識されない
- 確認方法:値の表記と文字列長を確認する
- 修正方法:前後空白を除き、空文字列を
pd.NAへ統一する - 修正後の確認:
isna().sum()と対象IDを再確認する
自分のDataFrameへ置き換える前のチェックリスト
df.columnsでsubsetへ指定する列名を確認したかisna().sum()で列ごとの欠損数を確認したか- 空文字列、空白、
-、不明など独自表記の意味を確認したか - 分析に必須の列と、欠損していても行を残せる列を分けたか
- 削除候補のIDを処理前に確認したか
- 削除候補が特定の地域・顧客・期間へ偏っていないか
- 処理後の行数、必須列の欠損数、残ったIDを確認したか
- 元のインデックスを残すか、
ignore_index=Trueで連番にするか決めたか - 元のDataFrameを残す必要がある場合、別変数へ保存したか
欠損値を削除したデータを集計へつなげる
最後に、amountの欠損を削除したdf_amountを商品別に集計します。削除後も金額があるA104・A107を残したため、これらの売上も集計へ反映されます。
実行目的
商品別の注文件数と売上合計を求め、前処理後のデータが次の分析へ使えることを確認します。
sales_by_product = (
    df_amount.groupby("product", as_index=False)
    .agg(注文件数=("order_id", "count"), 売上合計=("amount", "sum"))
    .sort_values("product")
    .reset_index(drop=True)
)

print(sales_by_product.to_string(index=False))
print("\n集計対象件数:", int(sales_by_product["注文件数"].sum()))
print("売上合計:", int(sales_by_product["売上合計"].sum()))| product | 注文件数 | 売上合計 | |
|---|---|---|---|
| 0 | Chair | 3 | 20000.0 |
| 1 | Monitor | 1 | 15000.0 |
| 2 | PC | 2 | 21000.0 |
集計対象件数: 6
売上合計: 56000
集計対象は6件、売上合計は56,000です。商品別ではPCが21,000、Chairが20,000、Monitorが15,000になります。
引数なしで欠損行をすべて削除していた場合、地域欠損のA104と顧客ID欠損のA107も集計から外れ、売上を12,000少なく数えてしまいます。どの列を基準に削除するかが、次の分析結果を変えることを確認してください。
複数列・複数集計の方法は、pandas groupby・aggの使い方で詳しく解説しています。
まとめ
dropna()は既定では、欠損値を1つでも含む行を削除する- 削除前に欠損の場所・意味・対象IDを確認する
- 通常は分析に必須の列だけを
subsetへ指定する how='all'はすべて欠損した行、threshは非欠損値数を基準にするhowとthreshは同時に指定できないaxis=1は列全体を削除するため、必要な列まで失わないか確認する- 空文字列は欠損値ではないため、表記を整えてから処理する
- 削除後は行数・欠損数・残ったID・集計結果を検算する
- 行を残す必要がある場合は、dropna()ではなくfillna()を検討する
dropna()は「欠損があるから消す」ための命令ではありません。何を分析するかを決め、必要な列を基準に削除し、結果を再確認してから集計や可視化へ進みましょう。
関連記事
howとthreshは同時に指定できますか?
できません。欠損が1つでもあるか・すべて欠損かで判断するならhow、非欠損値の最低個数で判断するならthreshを選び、片方だけを指定します。
空文字列がdropna()で消えないのはなぜですか?
空文字列''は文字列であり、欠損値ではないためです。業務上の意味を確認してから前後空白を除き、空文字列をpd.NAなどへ統一すると、dropna()の判定対象になります。
dropna()のあとにインデックスを振り直すにはどうしますか?
現行のpandasではignore_index=Trueを指定すると、結果のインデックスを0からの連番にできます。ただし元の行ラベルは失われるため、注文IDなどの識別列を残してください。より細かく整理する場合はreset_index()を使います。
dropna()とfillna()はどちらを選べばよいですか?
必須値がなく、その行を分析に使えないならdropna()を検討します。行を残す必要があるならfillna()を検討します。ただし、0や平均値による補完でデータの意味や分布が変わるため、補完値の根拠も確認してください。
コメント