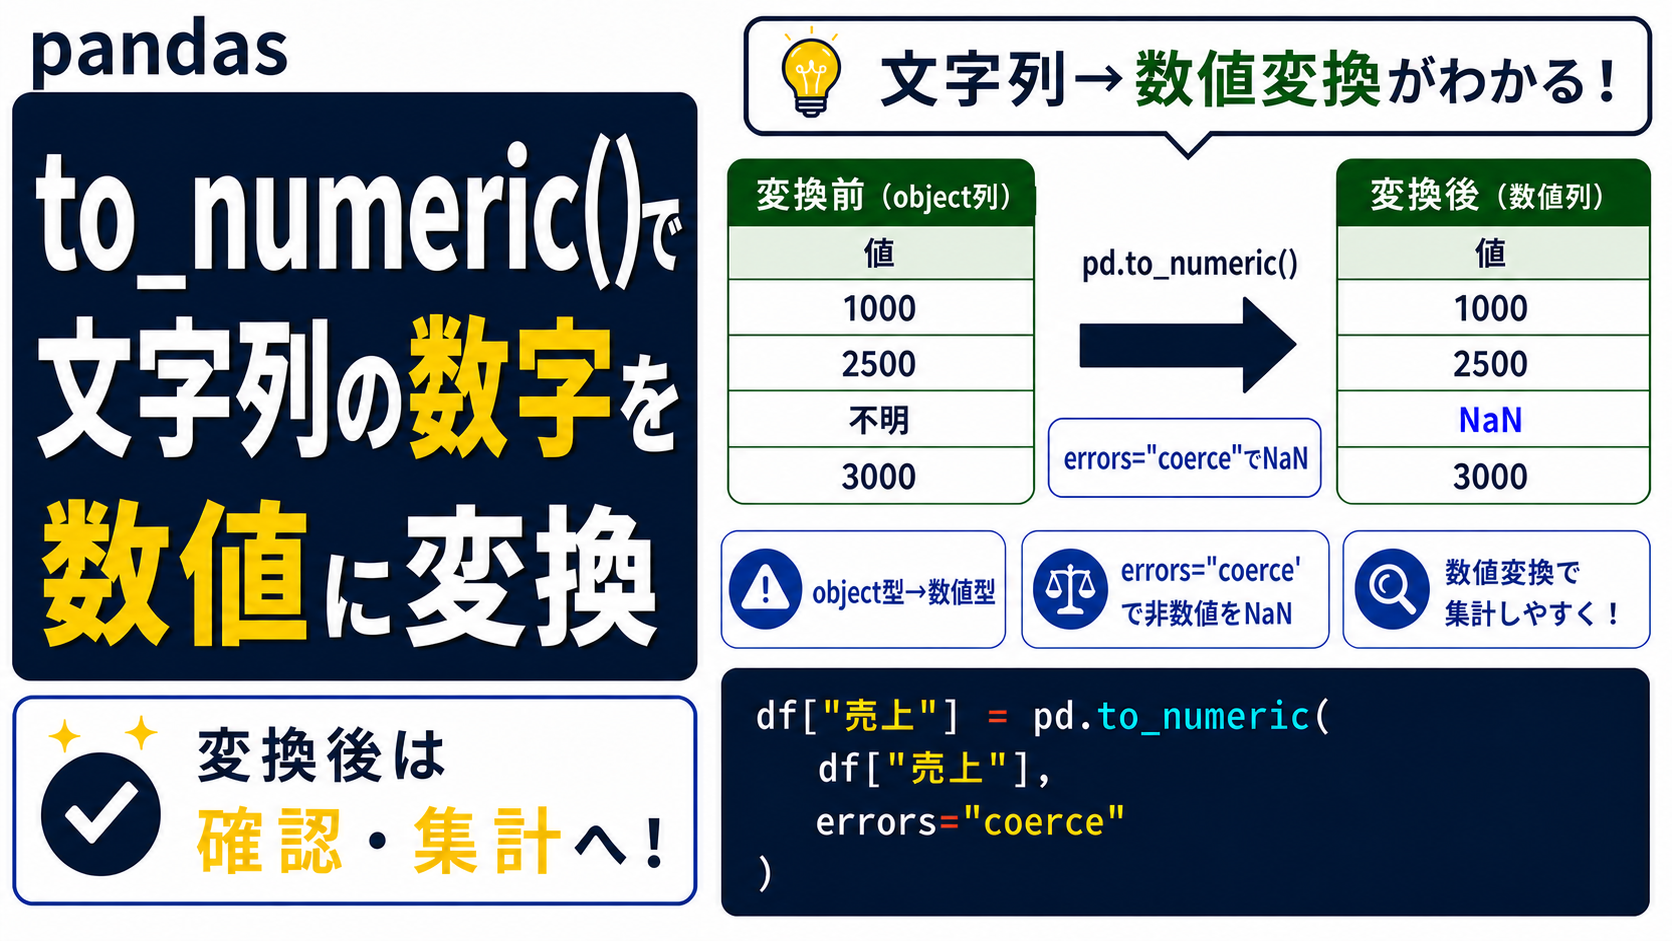
CSVやExcelから読み込んだ売上列が数字に見えるのに、object型になって計算できないことがあります。原因は、列の中にカンマや「円」、「-」、「不明」など、数値としてそのまま解釈できない文字が混ざっているためです。
このような列には、pd.to_numeric()が役立ちます。結論からいうと、変換できない値を発見しながら数値化したいときは、errors="coerce"を使い、変換後にNaNになった元値を必ず確認します。
errors="coerce"は、間違った値を自動修正する指定ではありません。変換できない値をNaNにして処理を続ける指定です。この記事では、どの値がNaNになったかを追跡し、修正・欠損扱い・除外を自分で判断できるところまで進みます。
この記事でわかること
-
pd.to_numeric()で文字列の数字を数値へ変換する方法 -
errors="raise"とerrors="coerce"の違い -
to_numeric()とastype()の使い分け - カンマや「円」を含む値の前処理
- 元からの欠損と、変換失敗で生じたNaNの見分け方
- 変換後に0埋め・修正・除外を選ぶ基準
この処理は、データ分析の流れではデータ読込後の型確認と前処理に位置します。
CSV読込・Excel読込 →
info()で型を確認 → 文字を清掃 →to_numeric()で数値化 → 変換失敗を確認 → 欠損処理 → 集計・可視化
to_numeric()・astype()・errorsの選び方
最初に、どの方法を選ぶか整理します。
| 方法 | 何をするか | 選ぶ場面 | 不正な値がある場合 | 注意点 |
|---|---|---|---|---|
astype(int)など |
指定した型へ変換 | 値がすべて整っていて、変換先の型が決まっている | 基本的にエラーで停止 | 不正値を探しながら変換する用途には不向き |
pd.to_numeric() |
数値へ変換 | 不正値があれば処理を止めて修正したい | 既定のerrors="raise"でエラー |
原因を直してから再実行する場合に向く |
pd.to_numeric(..., errors="coerce") |
変換できる値を数値化 | 不正値をNaNとして発見し、処理を続けたい | 変換できない値がNaNになる | NaNになった元値の確認が必須 |
判断の基本は、**きれいな値ならastype()、汚れた可能性がある数値列なら`to_numeric()`**です。
errors=”ignore”は使わない
古いコードではerrors="ignore"を見かけますが、一部の値だけを無視して残りを変換する指定ではありません。pandas
2.2で非推奨となり、確認したpandas
3.0系の公式APIではerrorsの選択肢はraiseとcoerceです。新しく書くコードでは使わず、処理を止めるか、NaNにして確認するかを選びましょう。
まずはきれいな文字列を数値へ変換する
最初に、数字だけで構成されたSeriesを変換します。pd.to_numeric()は、Seriesなどの1次元データを数値化するときに使います。
import pandas as pd

売上_文字列 = pd.Series(["1200", "1500", "2000"], name="売上_文字列")
売上_数値 = pd.to_numeric(売上_文字列)

pd.DataFrame({
    "変換前": 売上_文字列,
    "変換後": 売上_数値,
})| 変換前 | 変換後 | |
|---|---|---|
| 0 | 1200 | 1200 |
| 1 | 1500 | 1500 |
| 2 | 2000 | 2000 |
"1200"のような文字列が、計算できる数値へ変わりました。変換後のdtypeは入力値やpandasのバージョンによって変わる場合があるため、型名を暗記するのではなく、実際の出力で確認します。
print("変換前のdtype:", 売上_文字列.dtype)
print("変換後のdtype:", 売上_数値.dtype)
変換前のdtype: object
変換後のdtype: int64この例では、変換前は文字列を格納したobject型、変換後は整数型です。小数や欠損値が含まれる場合は、別の数値dtypeになることがあります。数値型になったかを確認することが大切です。
数値に変換できない値が混ざるデータを確認する
実際のCSVでは、数字以外の値が混ざります。ここでは次の8件を使います。
-
"1,500":カンマ付き -
"2,000円":カンマと通貨記号付き -
"-"、"不明":そのままでは数値化できない値 -
None:元からの欠損 -
"0":有効な0 -
"-300":返品などを表す可能性がある負数
0や負数は自動的に誤りと決めず、データの意味を確認します。
df = pd.DataFrame({
    "商品": ["A", "B", "C", "D", "E", "F", "G", "H"],
    "売上_元データ": ["1200", "1,500", "2,000円", "-", "不明", None, "0", "-300"],
})

df| 商品 | 売上_元データ | |
|---|---|---|
| 0 | A | 1200 |
| 1 | B | 1,500 |
| 2 | C | 2,000円 |
| 3 | D | – |
| 4 | E | 不明 |
| 5 | F | None |
| 6 | G | 0 |
| 7 | H | -300 |
まず、info()で列数、Non-Null
Count、dtypeを確認します。
df.info()<class 'pandas.core.frame.DataFrame'>
RangeIndex: 8 entries, 0 to 7
Data columns (total 2 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 商品 8 non-null object
1 売上_元データ 7 non-null object
dtypes: object(2)
memory usage: 260.0+ bytes売上_元データは8行中7件が非欠損で、dtypeはobjectです。objectと表示されたことだけで中身がすべて同じ種類の文字列とは限りません。実際の値も確認してから変換します。
既定のerrors=”raise”では変換できない値で停止する
errorsを指定しない場合はraiseです。数値として解釈できない値が見つかると、処理がエラーで停止します。
Notebookを上から実行できるよう、次のセルではtryとexceptでエラー名だけを確認します。
try:
    pd.to_numeric(df["売上_元データ"])
except ValueError as エラー:
    print("起きたエラー:", type(エラー).__name__)
    print("原因を含むメッセージ:", エラー)
起きたエラー: ValueError
原因を含むメッセージ: Unable to parse string "1,500" at position 1現象はValueErrorで変換が止まること、原因は"1,500"などをそのまま数値として解釈できないことです。
この段階でerrors="coerce"へ切り替えるだけでも処理は進みますが、カンマや「円」のように規則が明確な文字までNaNになります。まず、どの値が変換できないかを確認します。
errors=”coerce”の結果は元値と並べて読む
元の列は上書きせず、試しに変換した結果を別のSeriesとして並べます。
そのまま変換 = pd.to_numeric(df["売上_元データ"], errors="coerce")

pd.DataFrame({
    "元の値": df["売上_元データ"],
    "そのまま数値化": そのまま変換,
})| 元の値 | そのまま数値化 | |
|---|---|---|
| 0 | 1200 | 1200.0 |
| 1 | 1,500 | NaN |
| 2 | 2,000円 | NaN |
| 3 | – | NaN |
| 4 | 不明 | NaN |
| 5 | None | NaN |
| 6 | 0 | 0.0 |
| 7 | -300 | -300.0 |
"1200"、"0"、"-300"は数値になりました。一方、カンマ付き、円付き、"-"、"不明"はNaNです。NoneもNaNなので、出力のNaNだけを見ても、元から欠損していたのか、変換に失敗したのか区別できません。
これが、コードは動いても結果を誤解しやすいポイントです。次に、規則が明確な文字だけを清掃し、失敗理由を分けます。
カンマと「円」を除去してから数値化する
カンマと「円」は売上金額の装飾文字として使われていると分かっているため、変換前に除去します。表記ゆれや特定値の置換を詳しく確認したい場合は、pandas
replace()の使い方も参照してください。`astype(“string”)`を使うと、元のNoneを文字列"None"に変えず、欠損の<NA>として保持できます。
df["売上_清掃後"] = (
    df["売上_元データ"]
    .astype("string")
    .str.replace(",", "", regex=False)
    .str.replace("円", "", regex=False)
)

df["売上_数値"] = pd.to_numeric(df["売上_清掃後"], errors="coerce")

df[["商品", "売上_元データ", "売上_清掃後", "売上_数値"]]| 商品 | 売上_元データ | 売上_清掃後 | 売上_数値 | |
|---|---|---|---|---|
| 0 | A | 1200 | 1200 | 1200 |
| 1 | B | 1,500 | 1500 | 1500 |
| 2 | C | 2,000円 | 2000 | 2000 |
| 3 | D | – | – | <NA> |
| 4 | E | 不明 | 不明 | <NA> |
| 5 | F | None | <NA> | <NA> |
| 6 | G | 0 | 0 | 0 |
| 7 | H | -300 | -300 | -300 |
カンマ付きの"1,500"は1500、円付きの"2,000円"は2000へ変換できました。"-"と"不明"は、文字を除去しても数値の意味が確定しないためNaNのままです。
実際のデータへ置き換えるときは、海外形式の小数点・桁区切りに単純なカンマ除去を適用しないでください。表記規則を確認してから清掃します。
元からの欠損と変換失敗を分ける
次の2列を追加します。
-
元から欠損:入力時点ですでに欠損していた行 -
変換失敗:元値は存在したが、数値化後に欠損となった行
この判定があると、NaNを一律に0へ変える事故を防げます。
df["元から欠損"] = df["売上_元データ"].isna()
df["変換失敗"] = df["売上_数値"].isna() & df["売上_元データ"].notna()

df[[
    "商品", "売上_元データ", "売上_清掃後", "売上_数値",
    "元から欠損", "変換失敗"
]]| 商品 | 売上_元データ | 売上_清掃後 | 売上_数値 | 元から欠損 | 変換失敗 | |
|---|---|---|---|---|---|---|
| 0 | A | 1200 | 1200 | 1200 | False | False |
| 1 | B | 1,500 | 1500 | 1500 | False | False |
| 2 | C | 2,000円 | 2000 | 2000 | False | False |
| 3 | D | – | – | <NA> | False | True |
| 4 | E | 不明 | 不明 | <NA> | False | True |
| 5 | F | None | <NA> | <NA> | True | False |
| 6 | G | 0 | 0 | 0 | False | False |
| 7 | H | -300 | -300 | -300 | False | False |
処理前後表では、商品DとEだけが変換失敗=Trueです。商品Fは数値列でNaNですが、元から欠損=Trueなので変換失敗ではありません。商品Gの0と商品Hの負数は、変換可能な数値として残っています。
変換できなかった行だけを取り出して、元値を確認します。
df.loc[
    df["変換失敗"],
    ["商品", "売上_元データ", "売上_清掃後"]
]| 商品 | 売上_元データ | 売上_清掃後 | |
|---|---|---|---|
| 3 | D | – | – |
| 4 | E | 不明 | 不明 |
NaNを0で埋める前に意味を判断する
変換失敗値の扱いは、文字の意味によって変わります。
| 元の値・状態 | 考えられる意味 | 推奨する確認 | 処理例 |
|---|---|---|---|
"-" |
売上なし、未入力、対象外など | 入力ルールや作成者へ確認 | 売上なしと確認できた場合だけ0へ修正 |
"不明" |
金額が分からない | 原票や入力元を確認 | 判明すれば修正、分からなければ欠損のまま |
| 元からの欠損 | 未入力・取得失敗など | 欠損理由を確認 | 必要に応じてfillna()等を検討 |
"0" |
実際に売上0 | 0が有効値か確認 | 有効なら0のまま保持 |
"-300" |
返品・取消など | 負数が許される列か確認 | 正当なら負数のまま保持 |
ここでは、業務ルールを確認した結果、"-"だけが「売上なし」を表すと仮定します。"不明"と元からの欠損は、根拠なく0にせずNaNのまま残します。
df["売上_確定"] = df["売上_数値"].copy()
df.loc[df["売上_元データ"].eq("-"), "売上_確定"] = 0

df[["商品", "売上_元データ", "売上_数値", "売上_確定"]]| 商品 | 売上_元データ | 売上_数値 | 売上_確定 | |
|---|---|---|---|---|
| 0 | A | 1200 | 1200 | 1200 |
| 1 | B | 1,500 | 1500 | 1500 |
| 2 | C | 2,000円 | 2000 | 2000 |
| 3 | D | – | <NA> | 0 |
| 4 | E | 不明 | <NA> | <NA> |
| 5 | F | None | <NA> | <NA> |
| 6 | G | 0 | 0 | 0 |
| 7 | H | -300 | -300 | -300 |
商品Dだけが0へ修正され、"不明"の商品Eと元から欠損していた商品FはNaNのままです。0埋めはコード上できるかではなく、0と判断できる根拠があるかで決めます。
集計前に件数・欠損・dtypeを確認する
最後に、変換後のdtype、行数、数値として使える件数、欠損件数、合計、平均を確認します。
確認結果 = pd.Series({
    "dtype": str(df["売上_確定"].dtype),
    "全行数": len(df),
    "数値として使える件数": int(df["売上_確定"].notna().sum()),
    "欠損件数": int(df["売上_確定"].isna().sum()),
    "合計": float(df["売上_確定"].sum()),
    "平均": float(df["売上_確定"].mean()),
}, name="結果")

確認結果| 結果 | |
|---|---|
| dtype | Int64 |
| 全行数 | 8 |
| 数値として使える件数 | 6 |
| 欠損件数 | 2 |
| 合計 | 4400.0 |
| 平均 | 733.333333 |
全8行のうち、数値として使えるのは6件、欠損は2件です。合計は4,400、平均は約733.33です。pandasのsum()やmean()は通常、欠損値を除いて計算するため、平均の分母は8件ではなく数値がある6件です。
商品Hの-300も合計と平均へ含まれています。負数が返品として正しいのか、入力ミスなのかを確認せずに集計結果を解釈してはいけません。
自分のデータへ置き換えるときのチェックリスト
- 対象の列名が正しいか
-
info()やdtypeで変換前の型を確認したか - 元からの欠損数を記録したか
- カンマ、通貨記号、前後空白、全角数字、小数点、負数の表記を確認したか
- 0、未入力、不明、対象外がそれぞれ何を意味するか
- 元列を残したまま変換結果を検証したか
-
coerce後に増えたNaNの件数と元値を確認したか - 変換後のdtype、行数、欠損数、最小値・最大値に違和感がないか
特に、coerceでエラーが出なかったことを「全件正しく変換できた」と解釈しないでください。
数値化した後の分析へつなげる
数値化と失敗値の確認が終わったら、次の順で分析へ進めます。
- 欠損の意味を確認し、必要なら
fillna()等で処理する -
describe()で件数・平均・最小値・最大値を確認する -
groupby()とagg()で商品・店舗・月などの単位に集計する - 必要に応じてグラフで可視化する
to_numeric()は集計そのものではなく、正しく集計できる列を作る前処理です。変換後の値を確認してから次の工程へ進みましょう。
まとめ
- 文字列の数値を変換するには
pd.to_numeric()を使う - 値が整っていて型を明示するなら
astype()、不正値を探しながら変換するならto_numeric()を選ぶ - 既定の
errors="raise"は不正値で停止し、errors="coerce"は不正値をNaNにする -
errors="coerce"は自動修正ではないため、NaNになった元値を必ず確認する - カンマや「円」は規則を確認して変換前に清掃する
- 元からの欠損と変換失敗を分け、0・欠損・不明・負数を同一視しない
- dtype・件数・欠損数を確認してから、欠損処理や集計へ進む
大切なのは、変換コードを実行することではなく、変換で何が変わり、何が失われた可能性があるかを読めることです。
関連記事
- pandas info()の使い方|Non-Null Count・データ型・欠損値の見方
- pandas astype()の使い方|文字列・整数・小数の型変換とエラー対処
- pandas replace()の使い方|値の置換・表記ゆれ・欠損値変換を解説
- pandas str.strip()の使い方|文字列・列名の前後空白を削除
- pandas fillna()の使い方|欠損値を0・平均値・中央値で埋める方法
- Google ColabでCSVを読み込む方法|アップロード・Drive・read_csv
- pandas read_excel()の使い方|Excelファイル読み込み・sheet_name・usecolsを解説
- pandas describe()の使い方|統計量の意味と結果の見方を解説
- Pandas groupby×aggの使い方|基本の集計とaggの書き方を例で解説
to_numeric()とastype()はどう使い分けますか?
値がすべて整っていて、intなど変換先の型を明示したい場合はastype()が分かりやすい方法です。不正な文字が混ざる可能性があり、変換できない値をNaNとして発見したい場合はpd.to_numeric(..., errors="coerce")を選びます。
errors=”ignore”は現在も使えますか?
新しいコードでは使わないでください。古いpandasでは入力全体をそのまま返す挙動で誤解されやすく、pandas 2.2で非推奨となりました。確認したpandas 3.0系の公式APIでは、errorsの選択肢はraiseとcoerceです。
coerce後にNaNになった行だけを確認するには?
変換後の列へisna()を使い、元の列が欠損でなかった条件と組み合わせます。この記事の変換失敗列がその判定です。元列も一緒に表示すると、カンマ、記号、不明値などの原因を確認できます。
変換後が整数型ではなくfloat64などになるのはなぜですか?
小数やNaNを含む場合、整数だけの列とは異なるdtypeになることがあります。入力のdtypeやpandasのバージョンによってNullable整数型になる場合もあるため、型名を決めつけず、実際のdtypeを確認してください。
DataFrameの複数列をまとめてto_numeric()へ渡せますか?
pd.to_numeric()は主にSeriesなど1次元データへ使います。複数列は対象列を選んで列ごとに適用できますが、この記事では事故を防ぐため1列ずつ元値と結果を確認する方法に絞っています。
カンマ・円・全角数字はそのまま変換できますか?
常に変換できるとは限りません。カンマや「円」は表記規則を確認してから除去します。全角数字や海外形式の桁区切り・小数点は、データの規則に合わせた正規化が別途必要です。
変換後のNaNを0で埋めてもよいですか?
NaNが本当に「売上なし」を意味すると確認できる場合だけです。「不明」や取得失敗を0にすると分析結果が変わります。元値と業務上の意味を確認し、0への修正、欠損のまま保持、正しい値への修正、除外から選びます。
コメント