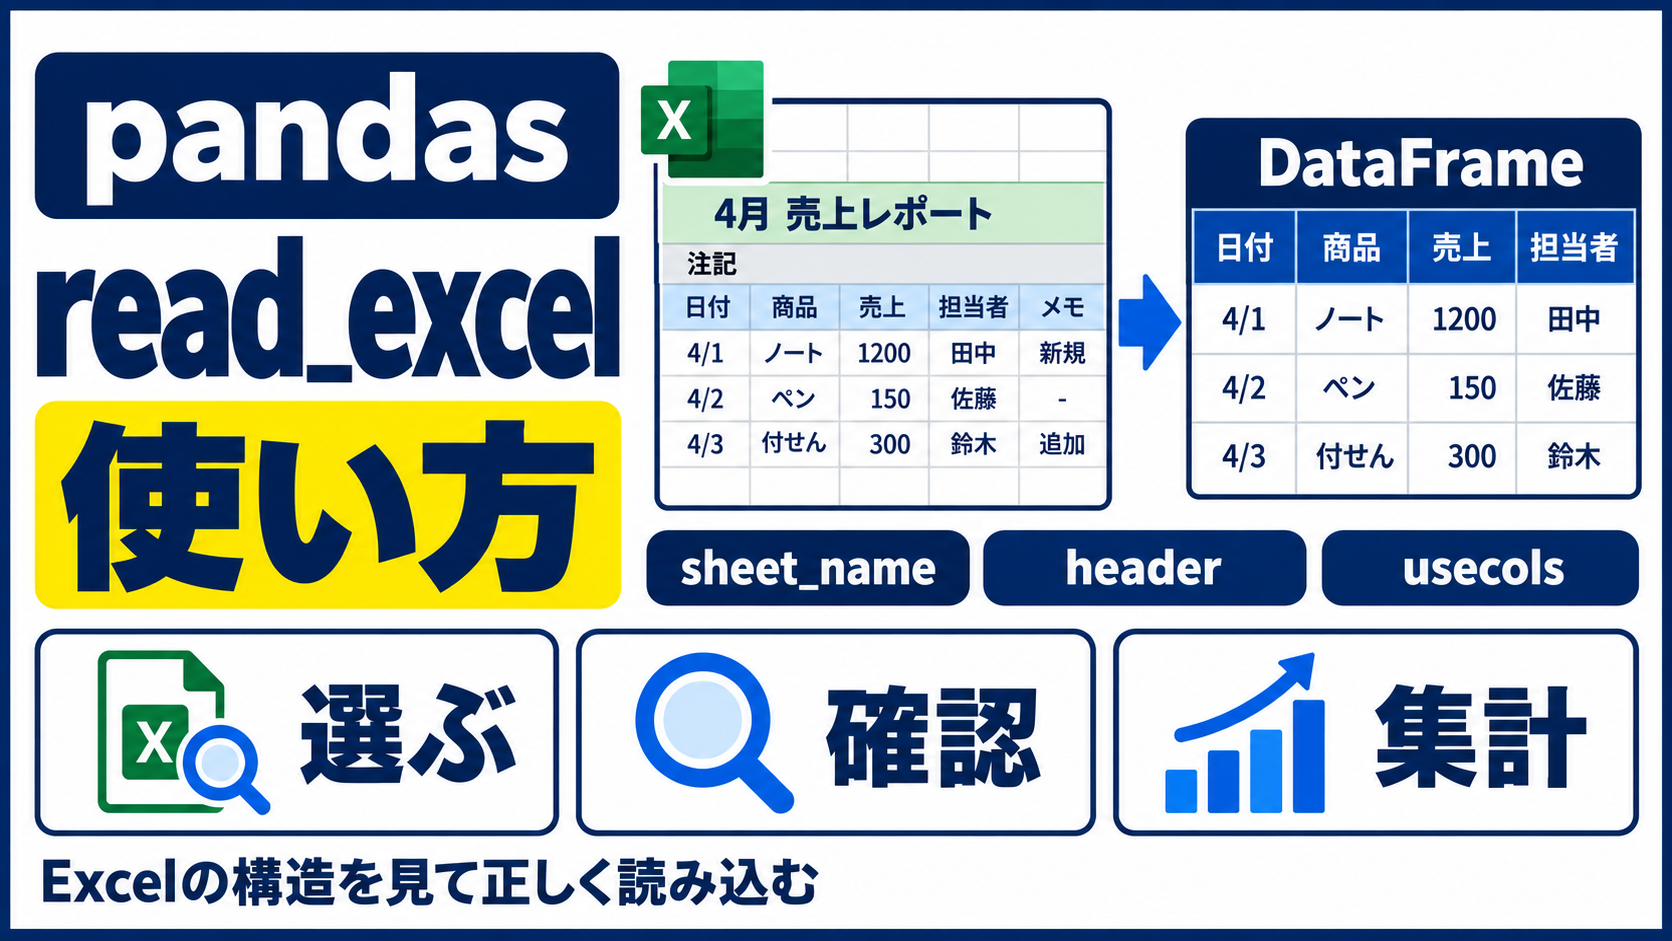
Excelファイルをpandasで読み込めても、タイトル行が列名になったり、違うシートや不要な列まで入ったりすると、その後の集計で迷います。
この記事では、Excelの構造を確認してから sheet_name・header・usecols を選び、読み込み後にDataFrameを検算する流れを解説します。Google Colabで上から順に実行できます。
この記事でわかること
pd.read_excel()でExcelをDataFrameへ読み込む基本- 読みたいシート、見出し行、必要な列の選び方
columns・head()・info()で正しく読めたか確認する方法- ファイルが見つからない、列名が想定と違う、型が合わないときの確認方法
この処理は、データ分析の「入力・確認」の工程です。読み込み後は、欠損値や型を整えてから集計・可視化へ進みます。
先に結論:Excelを見てから3つの指定を選ぶ
| Excelで確認すること | 指定するもの | 選ぶ場面 | 最初に確認する結果 |
|---|---|---|---|
| 読みたい表はどのシートか | sheet_name |
1枚目以外のシートを読む | 選んだシートの列名 |
| 見出しは何行目か | header または skiprows |
タイトル・注記が表の上にある | 列名と先頭データ |
| どの列を分析するか | usecols |
不要列を読まない | 必要な列だけか |
まずは指定を増やしすぎずに読み込み、df.columns、df.head()、df.info()で検算します。読み込みが成功しただけでは、分析に使える状態とは限りません。
import os
import pandas as pd
実行前:タイトル行と注記を含むExcelを用意する
ここでは再現用に、2つのシートを持つExcelを作ります。売上シートにはタイトル行、注記行、空行の後に見出し行があります。
実際のExcelでも、最初にこのような構造を確認してください。タイトルや注記をそのまま読んでしまうと、列名・型・集計結果がずれます。
source_sales = pd.DataFrame({
    "日付": ["2026-04-01", "2026-04-01", "2026-04-02", "2026-04-02"],
    "商品": ["ノート", "ペン", "ノート", "ペン"],
    "売上": [1200, 300, 1500, 450],
    "担当者": ["青木", "井上", "青木", "井上"],
    "社内メモ": ["通常", "通常", "確認済み", "通常"]
})

file_path = "sales_report.xlsx"
with pd.ExcelWriter(file_path, engine="openpyxl") as writer:
    source_sales.to_excel(writer, sheet_name="売上", index=False, startrow=3)
    pd.DataFrame({"月": ["4月"], "目標売上": [5000]}).to_excel(
        writer, sheet_name="集計用", index=False
    )

from openpyxl import load_workbook
book = load_workbook(file_path)
sheet = book["売上"]
sheet["A1"] = "2026年4月 売上レポート"
sheet["A2"] = "注記:金額は税込み"
book.save(file_path)

print(os.listdir())
['.config', 'sales_report.xlsx', 'sample_data']
処理前の 売上 シートは、1行目がタイトル、2行目が注記、4行目が列名です。したがって、タイトルと注記を飛ばして4行目を列名として読む必要があります。
基本:まずは1シートを読み込む
pd.read_excel()の最小形は、Excelファイルのパスを渡すだけです。複数シートがある場合、指定しなければ先頭のシートを読み込みます。
ただし今回は先頭シートでもタイトル行があるため、このままでは列名が正しくなりません。次のセルであえて確認します。
df_without_options = pd.read_excel(file_path)
display(df_without_options.head())
print("列名:", df_without_options.columns.tolist())| 2026年4月 売上レポート | Unnamed: 1 | Unnamed: 2 | Unnamed: 3 | Unnamed: 4 | |
|---|---|---|---|---|---|
| 0 | 注記:金額は税込み | NaN | NaN | NaN | NaN |
| 1 | NaN | NaN | NaN | NaN | NaN |
| 2 | 日付 | 商品 | 売上 | 担当者 | 社内メモ |
| 3 | 2026-04-01 | ノート | 1200 | 青木 | 通常 |
| 4 | 2026-04-01 | ペン | 300 | 井上 | 通常 |
列名: ['2026年4月 売上レポート', 'Unnamed: 1', 'Unnamed: 2', 'Unnamed: 3', 'Unnamed: 4']
この結果ではタイトルが列名になり、正しい表ではありません。コードは動いていても、出力を見なければ誤りに気付けません。
sheet_name・skiprows・usecolsを指定して正しく読む
sheet_name="売上":分析したいシートを名前で選びます。skiprows=3:タイトル・注記・空行を飛ばし、次の行を列名として使います。usecols="A:D":分析に必要な4列だけを読みます。社内メモはこの分析では使いません。
df = pd.read_excel(
    file_path,
    sheet_name="売上",
    skiprows=3,
    usecols="A:D"
)

display(df)
print("列名:", df.columns.tolist())
print("行数:", len(df))
df.info()| 日付 | 商品 | 売上 | 担当者 | |
|---|---|---|---|---|
| 0 | 2026-04-01 | ノート | 1200 | 青木 |
| 1 | 2026-04-01 | ペン | 300 | 井上 |
| 2 | 2026-04-02 | ノート | 1500 | 青木 |
| 3 | 2026-04-02 | ペン | 450 | 井上 |
列名: ['日付', '商品', '売上', '担当者']
行数: 4
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 4 entries, 0 to 3
Data columns (total 4 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   日付      4 non-null      object
 1   商品      4 non-null      object
 2   売上      4 non-null      int64
 3   担当者     4 non-null      object
dtypes: int64(1), object(3)
memory usage: 260.0+ bytes
出力では、列名が 日付・商品・売上・担当者 になり、4行の売上データだけが読めています。売上が整数型、日付が文字列型であることも info() で確認します。
日付を月別に集計する前には、日付をdatetime型へ変換する必要があります。読み込み直後に型を確認する理由は、見た目が日付や数値でもDataFrame内の型が違う場合があるためです。
headerとskiprowsはどう選ぶ?
見出し行より前を丸ごと飛ばすなら skiprows が分かりやすい選択です。Excelの0始まりの行番号で見出し行を直接指定するなら header を使えます。今回の見出しはExcelの4行目なので、header=3 でも同じ結果になります。
| Excelの状態 | 選択 | 注意点 |
|---|---|---|
| 見出しより上にタイトル・注記がある | skiprows |
飛ばした直後の行が列名になるか確認する |
| 見出しが何行目か明確 | header |
行番号は0始まり |
| Excelに見出しがない | header=None と names |
列名は自分で与える |
df_with_header = pd.read_excel(
    file_path, sheet_name="売上", header=3, usecols="A:D"
)

print("skiprowsで読んだ列名:", df.columns.tolist())
print("headerで読んだ列名:  ", df_with_header.columns.tolist())
print("同じ内容か:         ", df.equals(df_with_header))
skiprowsで読んだ列名: ['日付', '商品', '売上', '担当者'] headerで読んだ列名: ['日付', '商品', '売上', '担当者'] 同じ内容か: True
header と skiprows を同時に何となく増やすと、見出し行まで飛ばしてしまうことがあります。列名が Unnamed: 0 になったり、商品名が列名になったりしたら、まず header=None で数行を表示し、見出しの実際の位置を確認してから指定を直してください。
複数シートを読むと戻り値が変わる
sheet_name にリストまたは None を渡すと、戻り値はDataFrameではなく「シート名をキー、DataFrameを値にする辞書」です。1つの表として head() を呼べると思い込まないことが大切です。
sheets = pd.read_excel(file_path, sheet_name=["売上", "集計用"])
print(type(sheets))
print("読み込んだシート:", list(sheets.keys()))
display(sheets["集計用"])
<class 'dict'> 読み込んだシート: ['売上', '集計用']
| 月 | 目標売上 | |
|---|---|---|
| 0 | 4月 | 5000 |
複数シートを毎回処理する必要がないなら、初心者はまず必要な1シートだけを指定する方が、確認する対象を絞れて安全です。
よくある失敗:現象から直す場所を決める
| 現象 | 主な原因 | 確認方法 | 修正方針 |
|---|---|---|---|
FileNotFoundError |
パス・名前・拡張子が違う | os.listdir()でファイル名を見る |
アップロード先と file_path を一致させる |
| 列名が想定と違う | タイトル行や注記行を読んだ | header=None で先頭行を見る |
skiprows または header を調整する |
| 必要な列がない | usecols がExcelの列と合わない |
df.columns.tolist()を確認する |
実際の列名・列記号に合わせる |
| 数値や日付が文字列 | Excelのセル形式・値が混在 | df.info()でdtypeを見る |
必要な列だけ型を整える |
FileNotFoundErrorを確認する
Colabへ自分のExcelをアップロードした場合、保存されたファイル名を確認してから file_path に設定します。次のセルを実行し、一覧にある名前をそのまま使ってください。
# 自分のExcelをColabへアップロードする場合だけ、先頭の # を外して実行します。
# from google.colab import files
# uploaded = files.upload()

print("現在のExcelファイル:")
print([name for name in os.listdir() if name.lower().endswith((".xlsx", ".xls"))])
現在のExcelファイル: ['sales_report.xlsx']
型が想定と違うときは、読み込み後に必要な列だけ整える
今回の 日付 は文字列として読み込まれています。読み込み設定の誤りではなく、次の前処理で扱う問題です。列全体を無条件に変換せず、変換後に欠損が増えていないか確認します。
df_checked = df.copy()
df_checked["日付"] = pd.to_datetime(df_checked["日付"], errors="coerce")

display(df_checked)
print("日付の欠損数:", df_checked["日付"].isna().sum())
print("日付列の型:", df_checked["日付"].dtype)| 日付 | 商品 | 売上 | 担当者 | |
|---|---|---|---|---|
| 0 | 2026-04-01 | ノート | 1200 | 青木 |
| 1 | 2026-04-01 | ペン | 300 | 井上 |
| 2 | 2026-04-02 | ノート | 1500 | 青木 |
| 3 | 2026-04-02 | ペン | 450 | 井上 |
日付の欠損数: 0
日付列の型: datetime64[ns]
変換後の 日付 列が datetime64[ns] になり、欠損数が0なら、月別集計や時系列グラフの準備ができています。errors="coerce" を使うと変換できない値は NaT になるため、必ず欠損数を確認してください。
読み込み後は前処理・集計へ進む
Excelを正しく読み込んだ後は、次の順番で進むと安全です。
info()で列・型・欠損値を確認する- 列名や文字列の前後空白を整える
- 数値・日付を必要な型に変換する
groupby()で商品別や担当者別に集計する
たとえば今回なら、日付を変換した後に商品別の売上を集計できます。未確認の列や型のまま集計へ進まないことが大切です。
sales_by_product = (
    df_checked.groupby("商品", as_index=False)["売上"]
    .sum()
    .sort_values("売上", ascending=False)
)
display(sales_by_product)| 商品 | 売上 | |
|---|---|---|
| 0 | ノート | 2700 |
| 1 | ペン | 750 |
まとめ
read_excel()の前に、対象シート・見出し行・必要列をExcelで確認する- 特定シートは
sheet_name、表の上のタイトルや注記はskiprowsまたはheader、必要列だけならusecolsを使う - 読み込み後は
columns・head()・info()で、列名・データ・型を必ず検算する - 読み込み成功と分析可能は別であり、型や欠損を確認してから前処理・集計へ進む
関連記事
- Google ColabでCSVを読み込む方法:Colabで自分のファイルを読み込む手順
- pandas info()の使い方:読み込み後に列・型・欠損値を確認する
- pandas str.strip()の使い方:列名や文字列の前後空白を削除する
- pandas to_numeric()の使い方:文字列の数字を数値へ変換する
- Pandasデータ前処理の基本:読み込み後に確認する順番と処理の選び方
read_excel()で特定シートを読むには?
sheet_name="売上" のようにシート名を指定します。番号で指定する場合は0始まりです。
複数シートを読むとDataFrameではないのはなぜですか?
sheet_nameにリストやNoneを指定すると、シートごとのDataFrameをまとめた辞書が返ります。sheets["売上"]のように取り出します。
タイトル行を飛ばすには?
見出しの前にある行数をskiprowsに指定します。先にheader=Noneで先頭数行を確認すると、飛ばす行数を判断しやすくなります。
数値が文字列として読み込まれたらどうしますか?
まずinfo()で対象列の型を確認します。その後、必要な列だけpd.to_numeric(..., errors="coerce")で変換し、変換できなかった値が欠損になっていないか確認します。
Google ColabでFileNotFoundErrorになるのはなぜですか?
Colabにアップロードしたファイル名とfile_pathが一致していないことが多い原因です。os.listdir()で実際のファイル名を確認してください。
コメント